Создание анализатора Steam-тегов, работающего полностью в браузере, и тюнинг локальных LLM
Анализатор Steam-тегов, который работает прямо в браузере. Рассказываю, что пошло не так (много чего).
В этой статье
Работая над Pocket Cat Desktop, я начал экспериментировать с API Steam и LLM, чтобы упростить подбор тегов и поиск похожих игр. В итоге получился инструмент для анализа Steam-тегов, который работает прямо в браузере.
Рассказываю, что удалось реализовать, с какими проблемами столкнулся и что ещё предстоит исправить.
Почему теги важны
Теги Steam влияют на рекомендации, блок «Похожие продукты» и поисковые фильтры. А ещё формируют ожидания игроков. Слишком общие теги могут скрыть особенности нишевой игры, а неточные — привлечь не ту аудиторию.
Хотелось ответить на 3 вопроса:
- Не перенасыщен ли мой жанр?
- Какие теги используют похожие успешные игры?
- На что вообще может рассчитывать такая игра?
Анализатор получает описание игры и возвращает три списка, дополняя их обоснованиями и похожими играми:
- Основные теги, определяющие суть игры
- Дополнительные теги
- Потенциально вводящие в заблуждение теги, которые стоит перепроверить/убрать
Задача — предложить максимально точные теги, подходящие аудитории игры. Окончательно решать, действительно ли они её описывают, всё равно должен разработчик.
Без серверного инференса
Хотелось, чтобы рекомендации и аналитика работали на статическом сайте, без API для инференса, которое пришлось бы поддерживать и оплачивать. Данные собираются, а модели обучаются отдельно; результаты раздаёт CDN:
- База SQLite размером около 390 МБ, загружаемая через sql.js (WASM) из Cloudflare R2, где нет платы за исходящий трафик.
- Модели эмбеддингов, работающие через Transformers.js в Web Worker. Веса в формате ONNX с квантованием int8 занимают от 23 до 111 МБ на модель.
- Ранжировщик LightGBM, экспортированный в JSON размером 1 МБ. Для вычисления его результата хватает примерно 50 строк JavaScript.
- Набор векторов игр размером 8 МБ, поиск по которому — полный перебор с вычислением скалярного произведения.
- Ночной GitHub Action, обновляющий базу и JSON-файлы аналитики. Каждый день отдельный публичный репозиторий собирает из этого снапшотика сайт на GitHub Pages.
Пока всё укладывается в бесплатные лимиты. Единственный регулярный расход — домен, который у меня уже был.
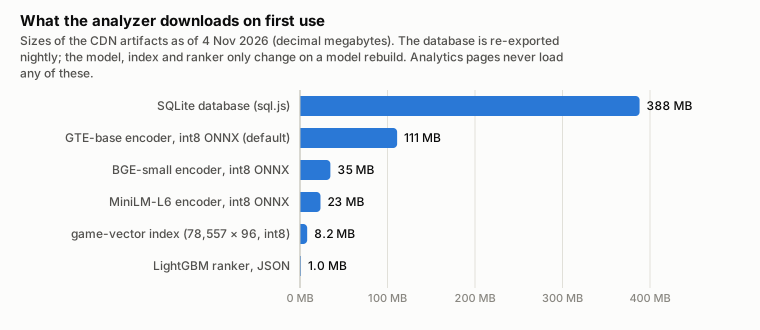
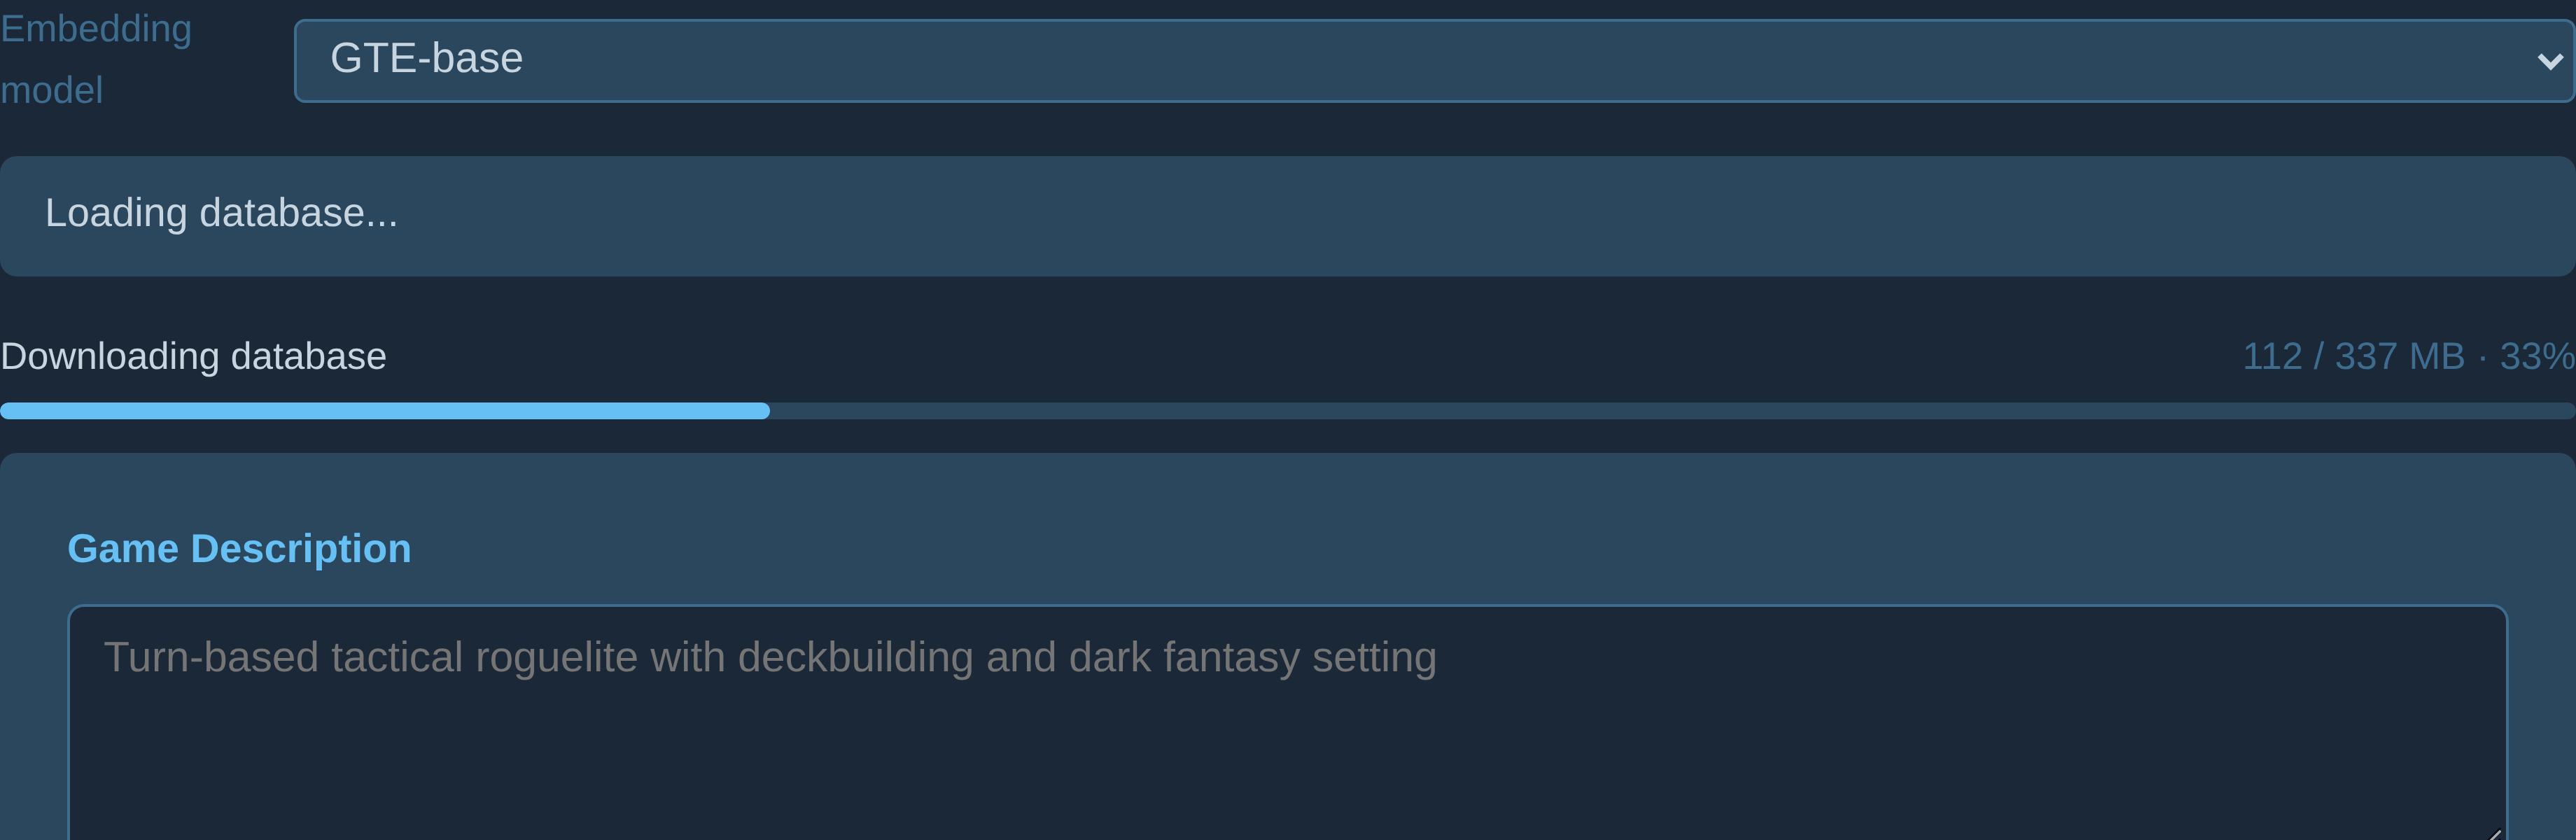
Главный недостаток — начальная загрузка: прежде чем выдать хоть какой-то результат, анализатору и проверке тегов нужна вся база. Страницы аналитики вместо неё используют небольшие JSON-файлы с заранее рассчитанными данными.
Данные и 4 проблемы при их сборе
Я собираю данные через IStoreService/GetAppList, эндпоинты отзывов, appdetails, публичный эндпоинт гистограмм отзывов и страницы магазина с тегами, за которые голосовали пользователи. Прогресс хранится в SQLite, поэтому продолжить сбор можно и на моём ноутбуке, и на CI-раннере.
Датасет в цифрах (база для браузера на 4 ноября 2026 года):
| Показатель | Значение |
|---|---|
| Найдено приложений | 199 541 |
| Вышедших игр | 129 914 |
| …с пригодным для работы описанием | 129 517 (в среднем 200 символов) |
| Назначений тегов с учётом порядка | 3 098 410 у 195 202 приложений (около 15.9 тега на приложение) |
| Тегов в классификаторе | 432 известных, 429 действующих |
| Вышедших игр с данными о числе отзывов | 129 914 (медиана — 19 отзывов) |
| Сегментов — по одному на каждый опорный тег | 405, с 90 167 строками коэффициентов lift |
| База для браузера / полная рабочая база | 388 МБ / 514 МБ |
Пример: Slay the Spire
App ID 646570, 220к отзывов, 97% положительных. Описание из магазина:
We fused card games and roguelikes together to make the best single player deckbuilder we could. Craft a unique deck, encounter bizarre creatures, discover relics of immense power, and Slay the Spire!
Теги в том порядке, в котором они идут в магазине. В скобках — отображаемые веса:
- Roguelike Deckbuilder (1 790)
- Card Game (1 650)
- Card Battler (1 577)
- Roguelike
- Deckbuilding
- Turn-Based
- Strategy
- Singleplayer
По документации Valve, первые 20 тегов влияют на видимость игры и рекомендации, а их веса учитывают и выбор разработчика, и теги игроков. Я использую первые 3 тега как приближённое описание сути игры. Это моя договорённость для обучения, а не определение Valve и не проверенная эталонная разметка; см. документацию Steamworks по тегам.
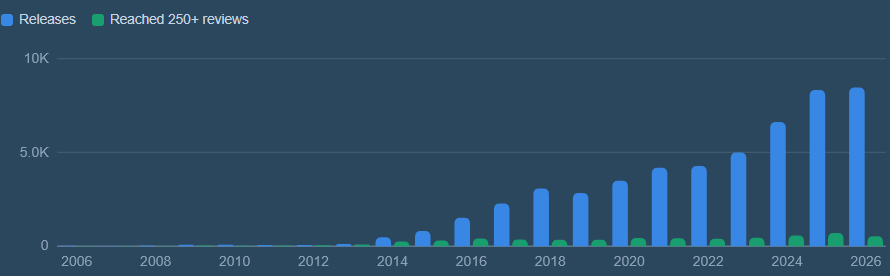
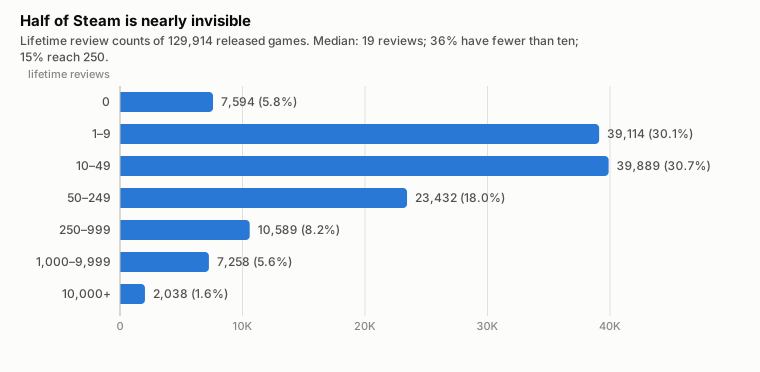
У половины вышедших игр в датасете 19 отзывов или меньше; у трети — меньше 10. Я использую отзывы как косвенный показатель вовлечённости, поэтому сравнение «успешных игр» напрямую не измеряет ни видимость, ни продажи, ни выручку.
При сборе обнаружились 4 проблемы:
- Лимит запросов. При 120 запросах в минуту часами крутился цикл c 429 →
Retry-After. В моих запусках эндпоинты магазина стабильно выдерживали примерно 40–60 запросов в минуту; с лимитом 50 сбор завершался быстрее, чем со 120. Эндпоинт гистограмм отзывов справлялся с 240+ запросами в минуту, но его предел я не выяснял. - Проверка возраста. 8 547 игр с полными данными, но без тегов, включая Quake, Hitman и Deus Ex. Страницы игр с возрастными ограничениями показывали проверку возраста, если я не передавал cookie с датой рождения. Добавление cookie исправило сбор; очередь повторных запросов помогла восстановить пропущенные данные.
- Обманчивые сводки отзывов. Параметр
day_rangeне ограничивал итоговые значения вquery_summary: игра с 215 795 отзывами возвращала 215 795 «недавних» отзывов. Несколько месяцев мой показатель динамики был просто общим числом отзывов за всё время. Теперь вычисляю разницу между успешными снимками, а с ноября ещё и записываю число прошедших дней. Но рекомендатель по-прежнему использует абсолютный прирост, а не скорость, поэтому разные интервалы обновления остаются проблемой. - Пустые ответы, выглядевшие успешными. Ночной запуск попытался получить отзывы для 5 000 игр и не собрал ничего, не сообщив об ошибке. GПерешёл на
IUserReviewsService/GetAppReviews, стал считатьHTTP 200без сводки ошибкой и прерывать обновление, если неудачей заканчивается более 80% запросов. При неудачном запросе должно сохраняться последнее известное число отзывов.
Почему бы просто не спросить чатбота?
Мне нужно ранжировать примерно 430 тегов с учётом релевантности тексту и статистики сегмента. Небольшие модели эмбеддингов и ранжировщик на деревьях укладываются в браузерные ограничения по объёму загрузки и вычислениям, не генерируя текст. Чатовая LLM тоже могла бы ранжировать теги, но контролируемого сравнения я не проводил.
Текущая реализация состоит из 2 этапов:
- Поиск кандидатов: один раз вычислить эмбеддинг описания, а затем собрать кандидатов из центроидов тегов, похожих игр и явно названных тегов.
- Оценка: ранжировать кандидатов по смысловой близости и статистике сегмента.
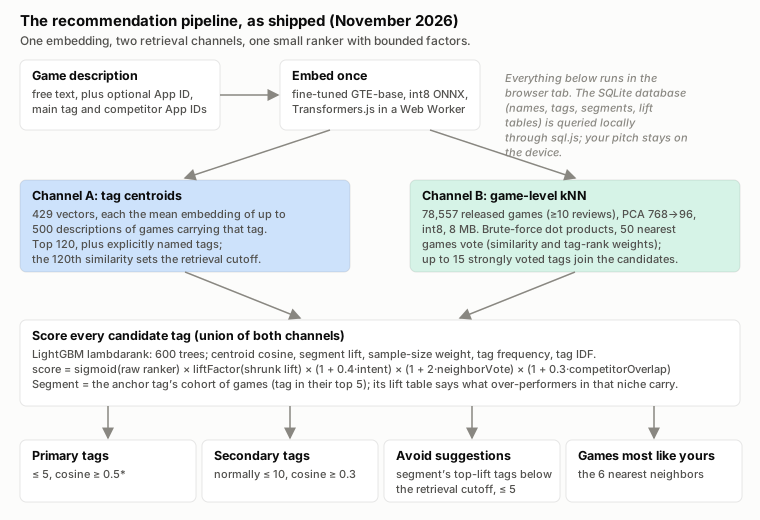
Поиск начинается со 120 ближайших центроидов, добавляет явно названные теги и может включить до 15 тегов с сильной поддержкой похожих игр. Затем правила выбирают до 5 основных и, как правило, 10 дополнительных тегов; явно упомянутые теги могут превысить лимит дополнительных. Это не отдельные обученные классификаторы для каждой группы.
3 небольшие модели, дообученные на данных Steam
Выбрал 3 модели эмбеддингов, которые можно квантовать и запускать в браузере:
| Ключ | Базовая модель | Размерность | int8 ONNX (в приложении) | Пулинг | Примечания |
|---|---|---|---|---|---|
minilm |
all-MiniLM-L6-v2 | 384 | 23 МБ | усреднение | самая быстрая загрузка; самая низкая полнота поиска в приведённом сравнении |
bge-small |
BAAI/bge-small-en-v1.5 | 384 | 35 МБ | CLS | моя дообученная версия использует префикс запроса |
gte-base (по умолчанию) |
thenlper/gte-base | 768 | 111 МБ | усреднение | длина последовательности ограничена 256 токенами, чтобы обучение помещалось в видеопамять 😭 |
Дообучил каждую модель на описаниях и тегах Steam, а затем квантовал для браузера.
Как дообучались модели
На каждый запуск выбирал до 100к вышедших игр с описанием длиннее 20 символов и хотя бы 3 тегами. Фиксированная контрольная выборка из 3 000 игр исключена из последующих дообучений энкодера.
Первые три тега каждой игры становятся положительными примерами. К каждому подбираю сложный отрицательный пример (семантически близкий тег), которого нет в сохранённом списке. Считать его отсутствие отрицательным примером — допущение для обучения: на самом деле тег может подходить. Для Slay the Spire получаются такие тройки:
("We fused card games and roguelikes together…", "Roguelike Deckbuilder", <hard negative>)
("We fused card games and roguelikes together…", "Card Game",             <hard negative>)
("We fused card games and roguelikes together…", "Card Battler",          <hard negative>)
Августовский запуск GTE-base дал около 260 000 троек. Я использую MultipleNegativesRankingLoss (MNRL) — контрастивную функцию потерь, а не триплетную с заданным отступом. Модель учится сопоставлять каждое описание с его положительным примером, предпочитая его другим положительным и явным отрицательным примерам в батче. Размер батча — 64, а для GTE-base — 16, чтобы уложиться в видеопамять.
Ограничения при подборе отрицательных примеров уменьшают число вероятных ложных отрицательных, но загрузчик с перемешиванием всё ещё считает совпадающие или повторяющиеся положительные теги внутри батча отрицательными. Это ограничение остаётся.
Обучаю 3 эпохи с lr 2e-5, линейным прогревом на 10% шагов и AMP. На RTX 5080 небольшим моделям нужны минуты, для GTE-base до часа. При внутренней валидации я измерял корреляцию косинусного сходства с условными метками: 1.0 для первых трёх тегов, 0.5 для позиций 4–5 и 0.0 для случайных тегов. Почти вся сходимость достигалась уже после одной эпохи. Эта валидация отделена от фиксированной контрольной выборки; качество поиска я оцениваю по метрикам восстановления тегов ниже.
Экспорт: optimum → ONNX → динамическое квантование int8 → структура каталогов, которую ожидает Transformers.js.
Две важные детали реализации:
- Поиск использует центроиды тегов. Каждый центроид — нормализованное среднее эмбеддингов описаний не более чем 500 игр, причём приоритет отдаётся играм, у которых тег стоит выше. «Cozy» представлен описаниями уютных игр, а не только названием тега, которое использовалось при обучении.
- Предобработка должна совпадать с обучением. Моя дообученная BGE добавляет к запросам и описаниям для векторов игр префикс "Represent this sentence for searching relevant passages:". К названиям тегов и описаниям для центроидов префикс не добавляется. Карточка модели BGE v1.5 допускает и запросы без префикса; здесь важно соответствие условиям дообучения.
Энкодер, центроиды, ранжировщик и векторы игр должны оставаться согласованными. Ежедневные обновления данных их не пересобирают.
Ранжировщик: 600 деревьев в JSON-файле
Объединяю семантическое сходство со статистикой сегментов через целевую функцию lambdarank в LightGBM (ранжировщик в духе LambdaMART). На каждую пару «игра - тег» он получает 5 признаков:
embed_similarity   cosine(description, tag centroid)
success_lift       P(tag | segment's top performers) / P(tag | segment)
confidence         heuristic weight from log-scaled tag sample size
tag_frequency      how common the tag is inside the segment
tag_idf            inverse document frequency across tagged games
Для обучения используется примерно 2 миллиона строк, сгруппированных по игре. Метки релевантности преобразуются в значения полезности: 1.0, 0.8 и 0.6 для позиций 1–3, 0.3 для позиций 4–10 и 0.1 для остальных. Пять выбранных неназначенных тегов на игру получают полезность 0. LambdaRank взвешивает градиенты попарного ранжирования по изменениям NDCG. Я обучаю 600 итераций, с максимумом в 31 лист на дерево и скоростью обучения 0.03, а затем экспортирую деревья в JSON размером около 1 МБ.
Целевая переменная — сохранённый порядок тегов, поэтому модель не предсказывает продажи или пользу от замены тега. confidence — эвристика на основе размера выборки, а не вероятность; IDF измеряет специфичность тега. От признаков глобальной популярности я отказался, потому что они поднимали Indie и Action выше более конкретных тегов.
Помогли 2 изменения:
- Более реалистичные отрицательные примеры. Случайные отрицательные теги вроде «Racing» для игры с построением колоды были слишком простыми по сравнению со 120 ближайшими центроидами, которые оцениваются при инференсе. Теперь 4 из 5 отрицательных примеров берутся из области высокого сходства, при этом 10 ближайших неназначенных тегов пропускаются, чтобы уменьшить число ложных отрицательных. Один пример остаётся случайным. Полнота восстановления основных тегов выросла на 1.6–2.3 процентного пункта у всех трёх моделей.
- Фиксированное число итераций. NDCG на валидации выходил на плато почти после первого дерева. Для одной модели ранняя остановка выбрала итерацию 1, и в приложение попал ранжировщик из одного дерева с полнотой 0.197 — ниже базового варианта по популярности. В моих экспериментах фиксированное число итераций решило эту проблему, хотя и не исключило переобучение. Нужна была валидация, лучше отражающая конечную задачу рекомендаций.
Как оценивается качество
Проверяем, может ли система восстановить сохранённые теги Steam. С фиксированным seed выбирается 500 вышедших игр с описаниями длиннее 20 символов, хотя бы 10 отзывами и не менее 5 тегами. Каждое описание становится запросом; ID игры нужен только для исключения её собственного вектора из kNN. Проверка использует Python-библиотеку sentence-transformers и Python-версию логики рекомендаций, поэтому не оценивает квантованный инференс в браузере.
id_recall@10 — доля первых 3-х тегов игры, найденных среди десяти рекомендаций, усреднённая по играм. Эта метрика не измеряет долю правильных рекомендаций. NDCG@10 учитывает ещё и порядок: полезность равна 1.0 для позиций 1–3, 0.5 для 4–10, 0.2 для остальных и нулю для тегов, которых нет в сохранённом списке. Эти значения отличаются от полезности при обучении ранжировщика. Базовый вариант, который всегда рекомендует одни и те же десять популярных тегов, включая Indie, Singleplayer и Action, дал полноту 0.370 на июльской выборке.
На графике показаны контролируемые сравнения до и после изменений на зафиксированных базах. В разных строках используются разные снимки, поэтому приросты нельзя складывать. В этой статье прирост полноты в «пунктах» везде означает процентные пункты.
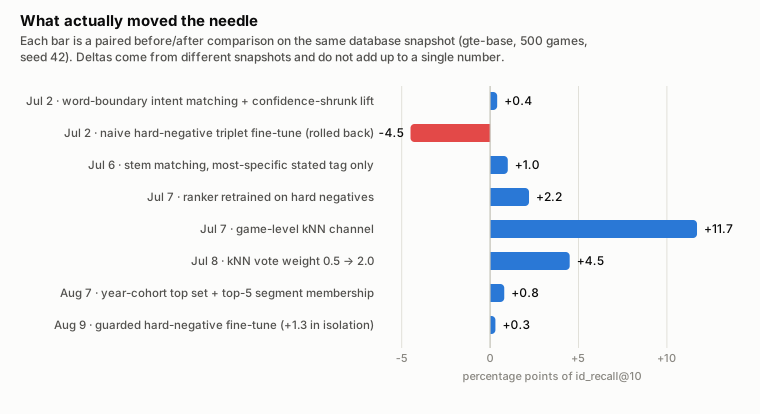
Четыре проблемы изменили взгляд на эти результаты:
- Меняющаяся база. Между первыми A/B-запусками менялся даже базовый результат по популярности: во время оценки фоновое обновление записывало данные в базу. Теперь я фиксирую снимок. Большая часть июльского скачка с 0.499 до 0.536 объяснялась изменением данных; контролируемый прирост составил всего 0.4 пункта.
- Ложные отрицательные примеры. Из-за ошибки первое дообучение создавало положительные пары «тег - тот же тег» вместо того, чтобы связывать подобранные отрицательные примеры с описаниями. Исправление на тройки «описание - положительный тег - отрицательный тег» снизило полноту на 4.5 пункта. Я заподозрил, что отсутствующие теги ошибочно считаются отрицательными, и откатил изменение. В августе попробовал снова с двумя ограничениями: пропускать десять ближайших неназначенных тегов и отбрасывать кандидатов, которые часто встречаются вместе с уже имеющимися тегами игры. Например, у Roguelike Deckbuilder может просто отсутствовать подходящий тег Deckbuilding. Второе ограничение отбросило 63% кандидатов, хотя это не доказывает ошибочность их разметки. Переработанный подбор отрицательных примеров отдельно дал 1.3 пункта, а после изменений сегментов, описанных ниже, — 0.3. Я не выделял вклад каждого ограничения и не проверял значимость меньшего прироста.
- Пересечение с обучающими данными. Вручную перефразировал 30 описаний: полнота составила 0.456 на исходных и 0.500 на перефразированных. В этой небольшой выборке перефразирование не снизило полноту, но это не исключает запоминания. В августе я зафиксировал 3 000 из 73 272 подходящих игр и исключил их из последующих дообучений энкодера. На выборке из 500 таких игр результат составил 0.655 против 0.693 на стандартной выборке — разрыв в 3.8 пункта. Отдельный результат с разрывом в 1.4 пункта (0.657 против 0.671) получен на непересекающихся выборках из контрольного пула и остальных игр. Ни одно из этих сравнений не выделяет эффект утечки данных в чистом виде.
- Ограниченная независимость контрольной выборки. Эти игры всё ещё участвуют в построении центроидов, обучении ранжировщика, расчёте совместной встречаемости и статистики сегментов, PCA и корпусе kNN. Исключение совпадения игры с самой собой не устраняет это пересечение. Результат 0.655 измеряет восстановление тегов для игр, исключённых из обучения энкодера, а не качество на совершенно новых играх или описаниях невышедших проектов.
Добавляем отдельные игры в поиск
Каждый центроид тега усредняет до 500 описаний, из-за чего сочетания жанров могут размываться. «Уютная хоррор-игра про рыбалку» может плохо соответствовать любому отдельному центроиду, но быть очень похожей на существующую игру. Очевидный пример — DREDGE.
Я добавил kNN по отдельным играм как второй источник кандидатов. Заранее кодирую вышедшие игры с пригодным описанием и хотя бы 10 отзывами: в этой сборке их 78 557. Для GTE-base PCA сокращает размерность с 768 до 96, сохраняя около 81% дисперсии эмбеддингов. Затем нормализую векторы до единичной длины, квантую в int8 и упаковываю в бинарный файл:
"GVEC" | version, count, dims, origDims, scale   (24-byte header)
mean[768] + PCA components[96×768]               (float32 — the projection)
appids[78,557]                                   (uint32 — row → game)
matrix[78,557 × 96]                              (int8 — unit vectors × 127)
Файл занимает 8.2 МБ. Названия, теги и число отзывов уже хранятся в SQLite, поэтому здесь нужны только ID и векторы. Браузер применяет к запросу то же преобразование PCA и перебирает все векторы: около 7.5 миллиона операций умножения со сложением, которые в моих тестах занимают миллисекунды. PCA и округление до int8 могут изменить состав соседей; сохранение дисперсии не гарантирует одинаковые результаты поиска.
50 ближайших игр голосуют за теги с весами, зависящими от неотрицательного сходства и позиции каждого тега. Голоса нормализуются по максимальной сумме голосов за один тег, без учёта числа отзывов. Это позволяет не добавлять ещё одно преимущество популярным играм, хотя сам корпус всё равно исключает игры с числом отзывов меньше десяти. Если запрос содержит App ID, я убираю собственный вектор этой игры.
Эти соседи также заменили «игры с наибольшим числом отзывов в сегменте» в списке похожих игр.
Добавление kNN дало 11.7 пункта полноты — примерно в пять раз больше, чем любое другое изменение, которое я до этого пробовал. Я заподозрил утечку данных, но исключение совпадений с самой игрой, а затем и соседей со сходством выше 0.85 почти не изменило прирост. Эта проверка не выявляет все дубликаты и не устраняет описанное выше пересечение с обучающими данными.
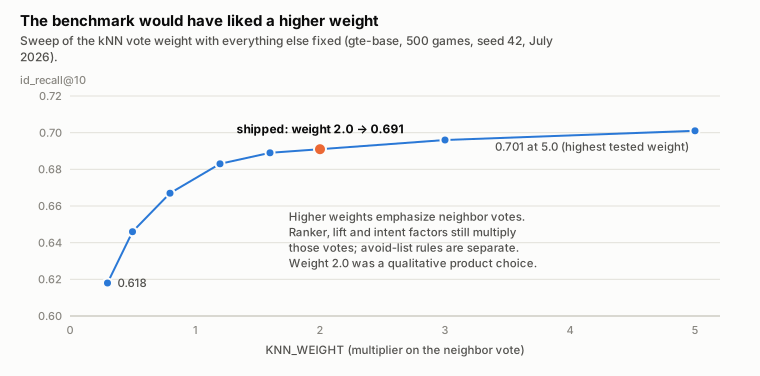
Увеличение веса голосов подняло полноту с 0.691 при весе 2.0 до 0.701 при 5.0. Если оценку B × (1 + w × v) разделить на w, получится B × (1/w + v): больший вес усиливает влияние голосов соседей, сохраняя множители в B — ранжировщик, lift, явно упомянутые теги и пересечение с конкурентами. Правила списка нежелательных тегов работают отдельно.
Посмотрев на рекомендации, я оставил 2.0, пожертвовав одним пунктом полноты. Это субъективный выбор; я не измерял, помогает ли он разработчикам.
Формула оценки и баг «dwarf → War»
Итоговая оценка получается применением сигмоиды к выходу ранжировщика и умножением на коэффициенты с ограниченными диапазонами:
score = sigmoid(rawRankerScore)
      × liftFactor(shrunkLift)        # within-segment commercial lift
      × (1 + 0.4 × intent)            # tags the user explicitly wrote
      × (1 + 2.0 × neighborVote)      # tags similar games use
      × (1 + 0.3 × competitorOverlap) # tags the named competitors share
Это не вероятность: сигмоида переводит исходную оценку в диапазон (0, 1), но итоговый результат может превышать 1. Формулы shrunkLift = 1 + confidence × (lift − 1) и liftFactor = 1 + 0.5 × (clamp(shrunkLift, 0.5, 3.0) − 1) дают множитель lift в диапазоне 0.75–2.0. Голоса соседей, показатель явно упомянутых тегов и пересечение с конкурентами находятся в диапазоне [0, 1].
Чтобы эти множители работали правильно, пришлось сделать несколько исправлений:
- Поиск явно упомянутых тегов. Мой поиск по подстроке усиливал «War» при слове «dwarf» (d-war-f). Добавилисась проверка границ слов, а затем сопоставление по общей начальной части для слов вроде «deckbuilding» и «deckbuilder». Оно всё ещё смешивает «roguelite» и «roguelike». Приоритет получают конкретные составные теги: «dark fantasy» усиливает Dark Fantasy, а не Dark и Fantasy по отдельности; частичные совпадения не усиливают Action Roguelike или Online Co-Op. Затем один из проверявших попробовал «a solo game with no multiplayer» — одиночную игру без мультиплеера — и получил усиление Multiplayer. Теперь я отбрасываю части фразы с отрицанием и нормализую
co-op/coop/co op. Эти лексические правила не мешают поиску по эмбеддингам или соседям возвращать теги, которые в тексте отрицаются. - Сглаживание lift. Коэффициент lift по выборке из трёх игр ненадёжен, поэтому я стягиваю его к 1.0 с помощью веса, зависящего от размера выборки. Это эвристика, а не подобранная по данным статистическая модель.
- Перекос сегментов. Сегмент объединяет игры с определённым опорным тегом. В число лучших попадали верхние 20% по оценке, которая на 60% зависела от процентильного ранга числа отзывов, на 25% — от сглаженной доли положительных отзывов, а на 15% — от динамики числа отзывов. Старые игры доминировали: lift у Great Soundtrack был 3.2×, а у Classic — 3.0×. Оценка внутри когорт по году выхода приблизила эти значения к 1.0, тогда как контрольный тег, характерный для современных игр, остался стабильным. Маленькие когорты и игры с неизвестным годом объединяются, а срок присутствия в магазине всё ещё различается даже внутри одного года. Я также расширил критерий включения в сегмент: вместо опорного тега на позиции 1 достаточно его присутствия в первых 5 тегах. Так число игр в Souls-like выросло со 148 до 819. Вместе эти изменения дали 0.8 пункта полноты, в основном среди игр с небольшим числом отзывов. Отдельно удаление 826 неиспользуемых подсегментов «год × цена» сократило расчёт оценок с 13 минут до 19 секунд.
- Список нежелательных тегов. Он месяцами оставался пустым, потому что я искал теги с высоким lift и низкой релевантностью среди самых релевантных кандидатов. Теперь я начинаю с тегов сегмента с наибольшим lift и сравниваю их сходство с порогом 120-го кандидата для запроса. Для описания игры с построением колоды в мрачном фэнтезийном мире были отмечены Anime, Cute, Cartoony, а для сюжетной игры о переживании утраты — Open World и Family Friendly. Сначала я назвал эти результаты «пугающе хорошими», но слабая поддержка текстом не делает тег неверным: в мрачном фэнтези вполне может быть милая графика. Это предложения для перепроверки. Некоторые сгенерированные объяснения всё ещё звучат слишком уверенно, утверждая, что тег «привлечёт не ту аудиторию».
Как это выглядит на практике
Ввод с моделью по умолчанию, ноябрь 2026 года (перевод с английского):
Turn-based tactical roguelite with deckbuilding and a dark fantasy setting. You lead a doomed company of mercenaries across procedurally generated maps; permadeath, no meta-progression, every run tells its own story.
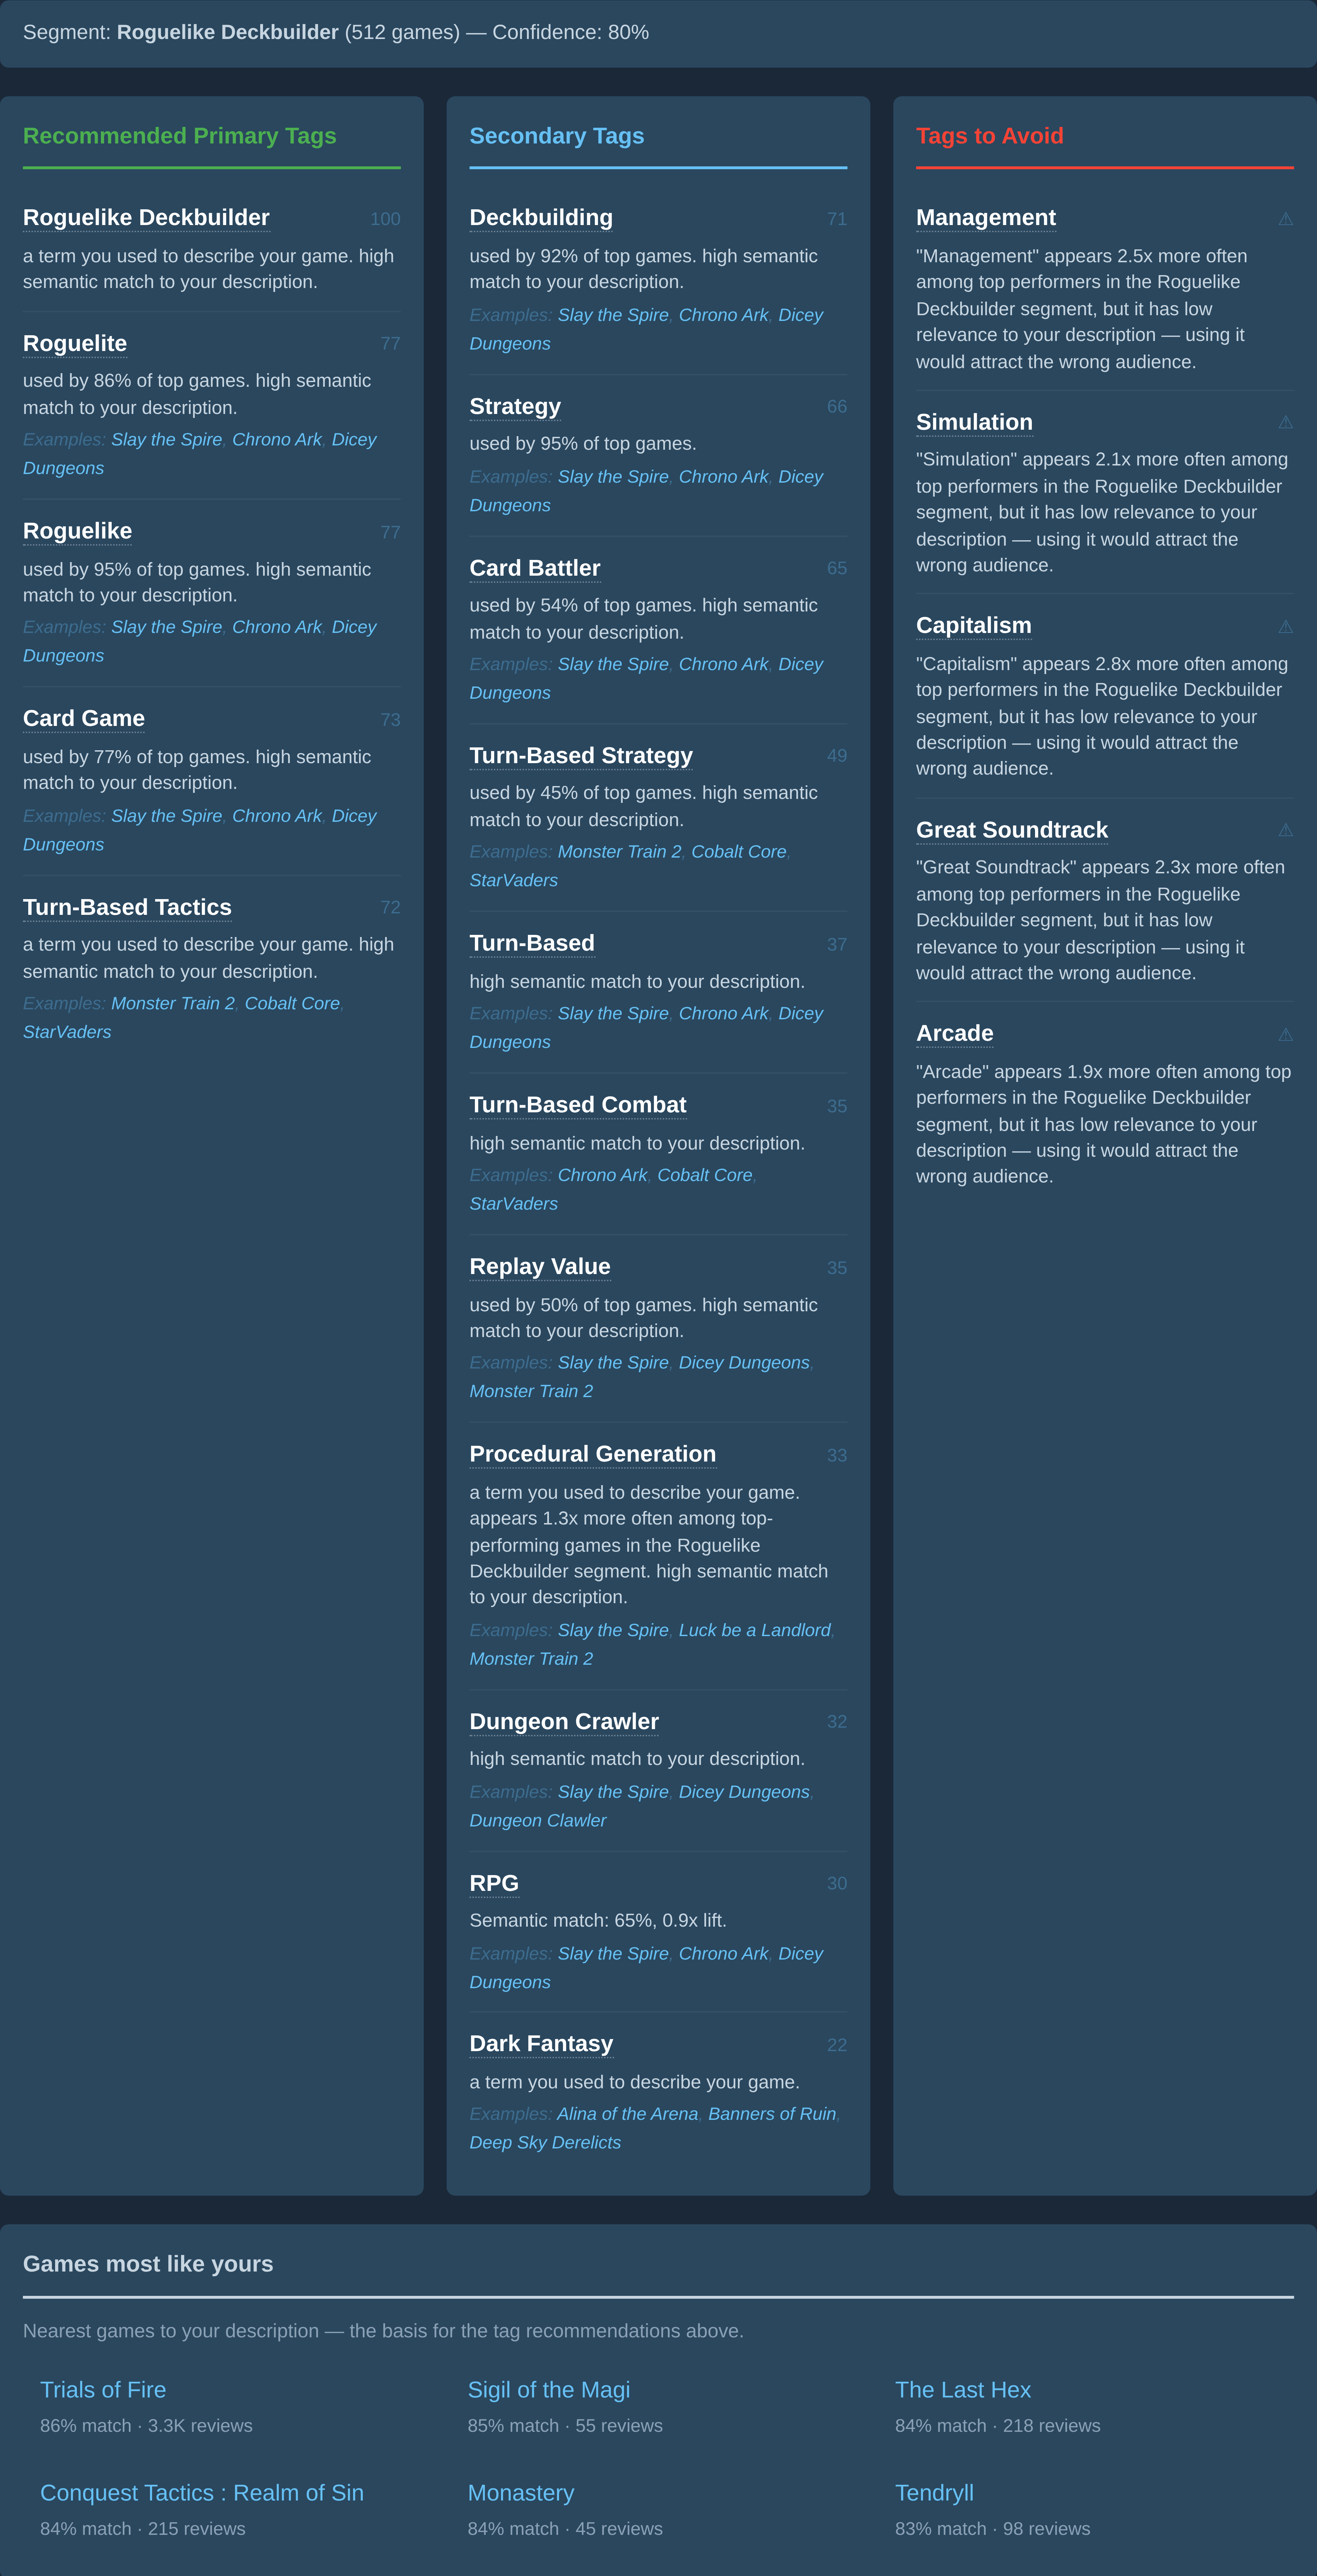
Определённый системой сегмент — Roguelike Deckbuilder, 512 игр. Результат:
- Основные: Roguelike Deckbuilder, Roguelite, Roguelike, Card Game, Turn-Based Tactics.
- Дополнительные: Deckbuilding, Strategy, Card Battler, Turn-Based Strategy, Turn-Based, Turn-Based Combat, Replay Value, Procedural Generation, Dungeon Crawler, RPG и Dark Fantasy.
- Похожие игры: Trials of Fire («86% совпадения»), Sigil of the Magi, The Last Hex, Conquest Tactics, Monastery и Tendryll.
- Теги для перепроверки: Management, Simulation, Capitalism, Great Soundtrack, Arcade.
Management, Simulation и Capitalism подходят части сегмента с играми в духе Luck be a Landlord, но не находят подтверждения в этом описании. Great Soundtrack указывает на баг: список нежелательных тегов пока не отфильтровывает хвалебные теги так, как это делают страницы аналитики. А «86% совпадения» — округлённое сходство эмбеддингов × 100, а не вероятность и не коммерческое сравнение.
Для описания уютной хоррор-игры про рыбалку первым оказывается DREDGE. Именно такие полезные связи я и хотел находить с помощью инструмента.
Проверка существующих Steam-страниц
В сентябре адаптировал систему для проверки тегов, уже стоящих на странице магазина. Один игрок обратил внимание на тег «Family Friendly» у Elden Ring на 20-м месте, с 1 419 голосами. Это и подтолкнуло меня к созданию проверки тегов.
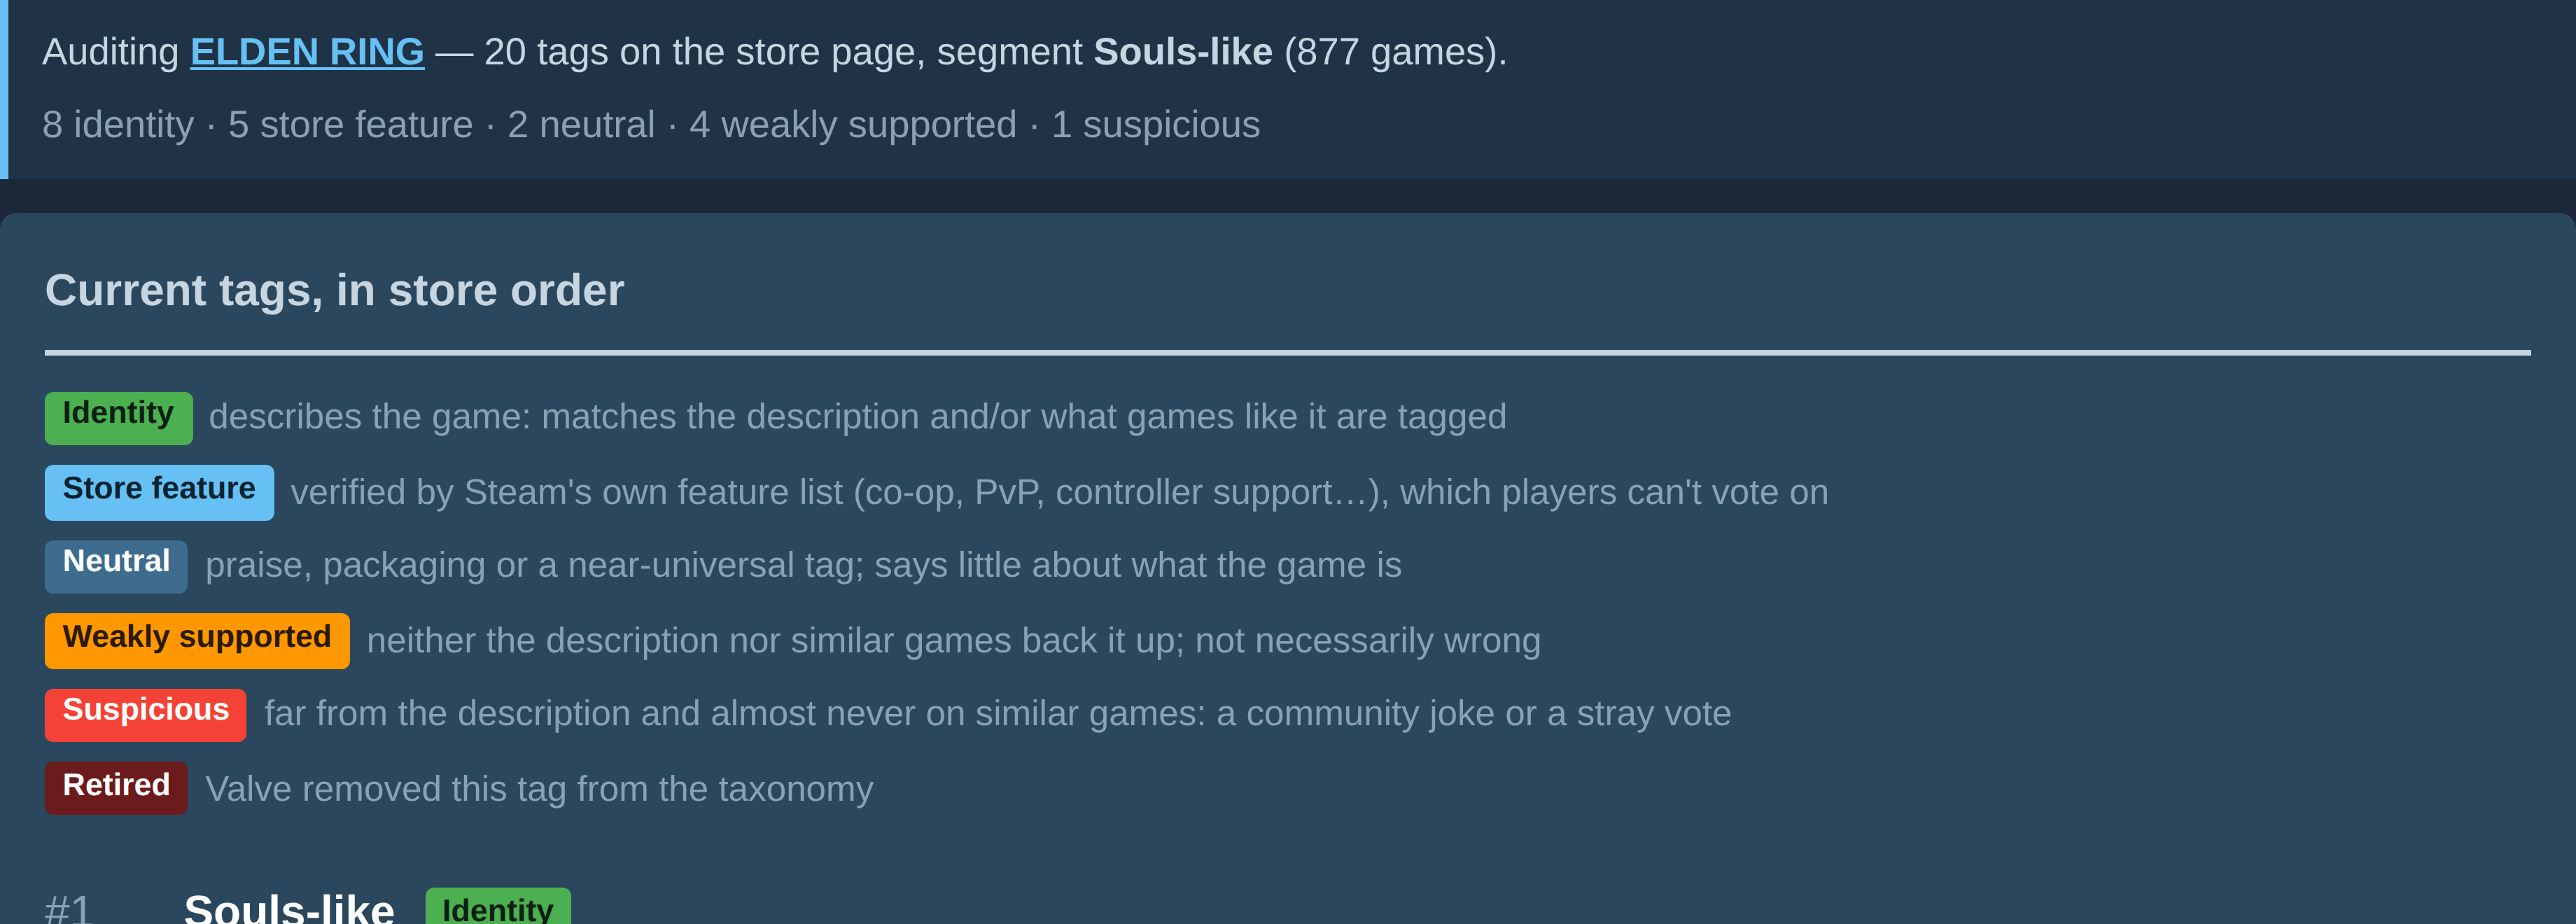
По App ID она относит существующие теги к одной из категорий: основной, подтверждённая характеристика магазина, нейтральный, слабо обоснованный, подозрительный или выведенный из употребления. Также показывает похожие игры и их теги, которых нет у проверяемой игры. Категория «подозрительный» рассматривается последней.
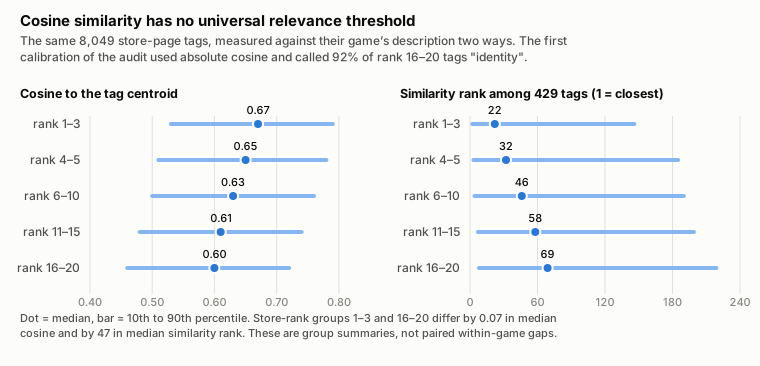
Первое правило использовало пороги косинусного сходства 0.5/0.3 из анализатора. При пороге ≥ 0.5 оно относило 92% тегов на позициях 16–20 в магазине к основным. Эти пороги работают вместе с ранжированием и ограничениями числа результатов в анализаторе, но оказались плохими самостоятельными правилами проверки.
Позиция в рейтинге сходства оказалась полезнее. У тегов на позициях 1–3 в магазине медиана косинусного сходства составляла 0.67, а медианная позиция по сходству — 22; для позиций 16–20 медианы были 0.60 и 69. Это медианы по группам, а не попарные сравнения внутри каждой игры, и ни один из показателей не даёт вероятности правильности тега.
Кроме того, по одному тексту нельзя отличить шуточный тег от характеристики, о которой забыли упомянуть в описании. Прежде чем пометить тег, проверка смотрит на заявленные разработчиком возможности — мультиплеер, кооператив, PvP, поддержку контроллера и VR, — а также на данные похожих игр. «Подтверждённая характеристика магазина» означает совпадение с метаданными магазина, а не независимую проверку Valve или мной. Некоторые соответствия довольно широкие: категория мультиплеера не доказывает наличие асинхронной игры.
После проверок на основной тег, характеристику и нейтральную категорию тег может считаться подозрительным, если выполняется одно из двух условий:
- Его сходство ниже порога поиска кандидатов для запроса и он не встречается ни у одного соседа.
- Его позиция по сходству хуже 300-й и он встречается не более чем у 6% соседей.
У меня нет независимо размеченной выборки неправильных тегов. Пометки среди первых трёх тегов магазина служат косвенным показателем ложных тревог — при допущении, что эти теги обычно верны. Без разметки доля пометок ни в начале, ни в конце списка не измеряет точность или полноту.
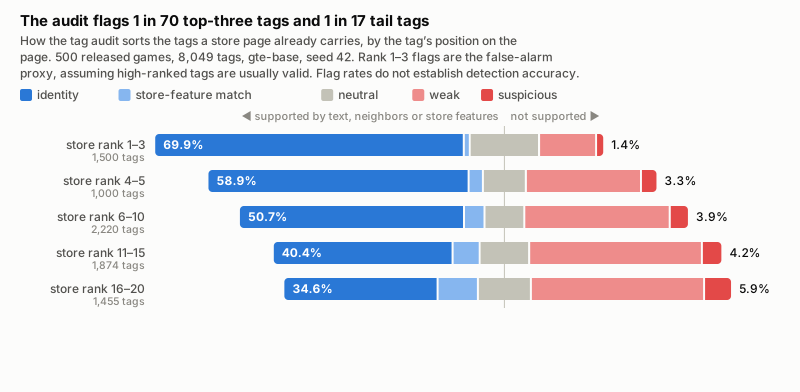
В выборке, исключённой из обучения энкодера, были помечены 1.7% первых трёх тегов и 6.3% тегов в конце списка, против 1.4% и 5.9% в стандартной выборке. Различия выборок и неизмеренная неопределённость не позволяют сделать уверенный вывод об обобщающей способности. Более мягкие правила давали больше пометок среди первых трёх тегов, часто затрагивая подходящие теги, которые не были упомянуты в описаниях: Card Game у текста, сосредоточенного на сеттинге, или RTS у описания Total Annihilation, рассказывающего только о мире игры.
Один баг оказался проще: когда файл kNN не скачивался, проверка трактовала отсутствие данных о соседях как аргумент против тега. Теперь она показывает «недостаточно данных» и не выдаёт вердикты на основе соседей и список нежелательных тегов, пока данные не появятся.
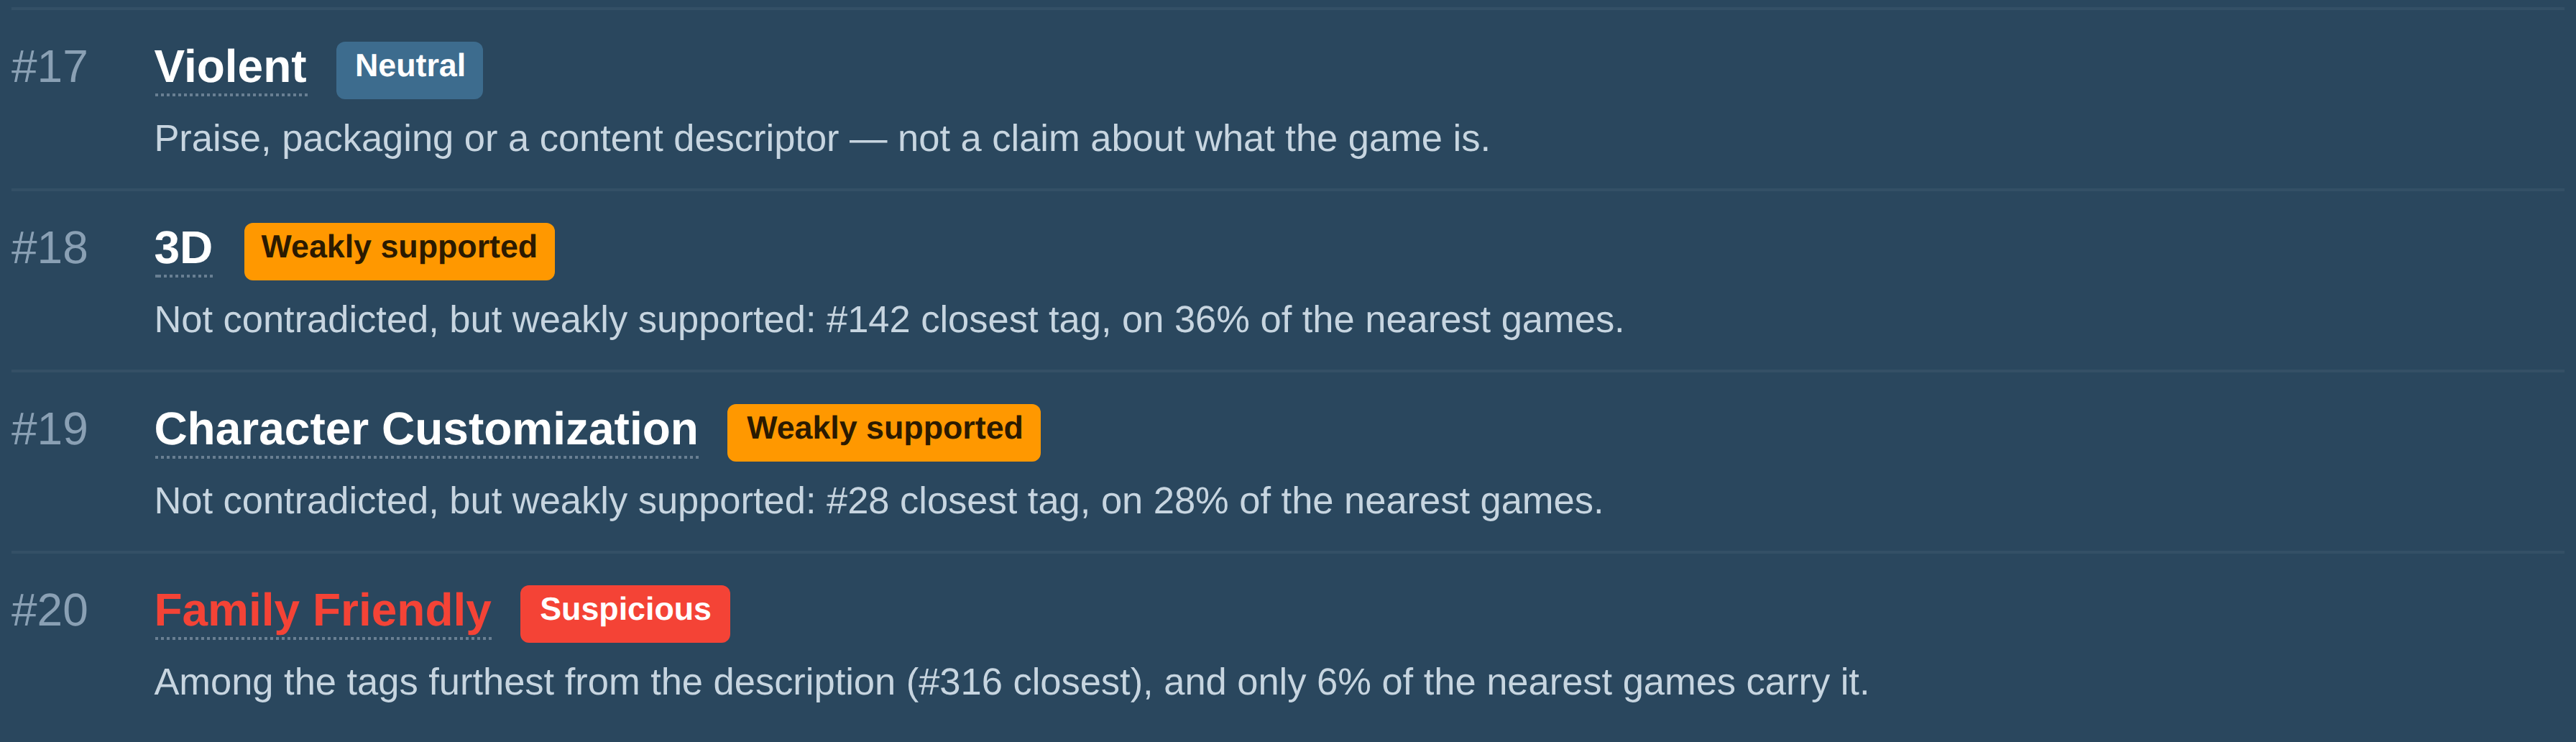
На ноябрьских данных Elden Ring получает восемь основных тегов, пять совпадений с характеристиками магазина (Multiplayer, Online Co-Op, Co-op, PvP, Singleplayer), два нейтральных хвалебных тега и четыре слабо обоснованных (Difficult, Atmospheric, 3D, Character Customization). Подозрителен только Family Friendly: он занимает 316-е место среди 429 тегов по сходству и встречается у 6% из пятидесяти ближайших игр.
Страницы аналитики
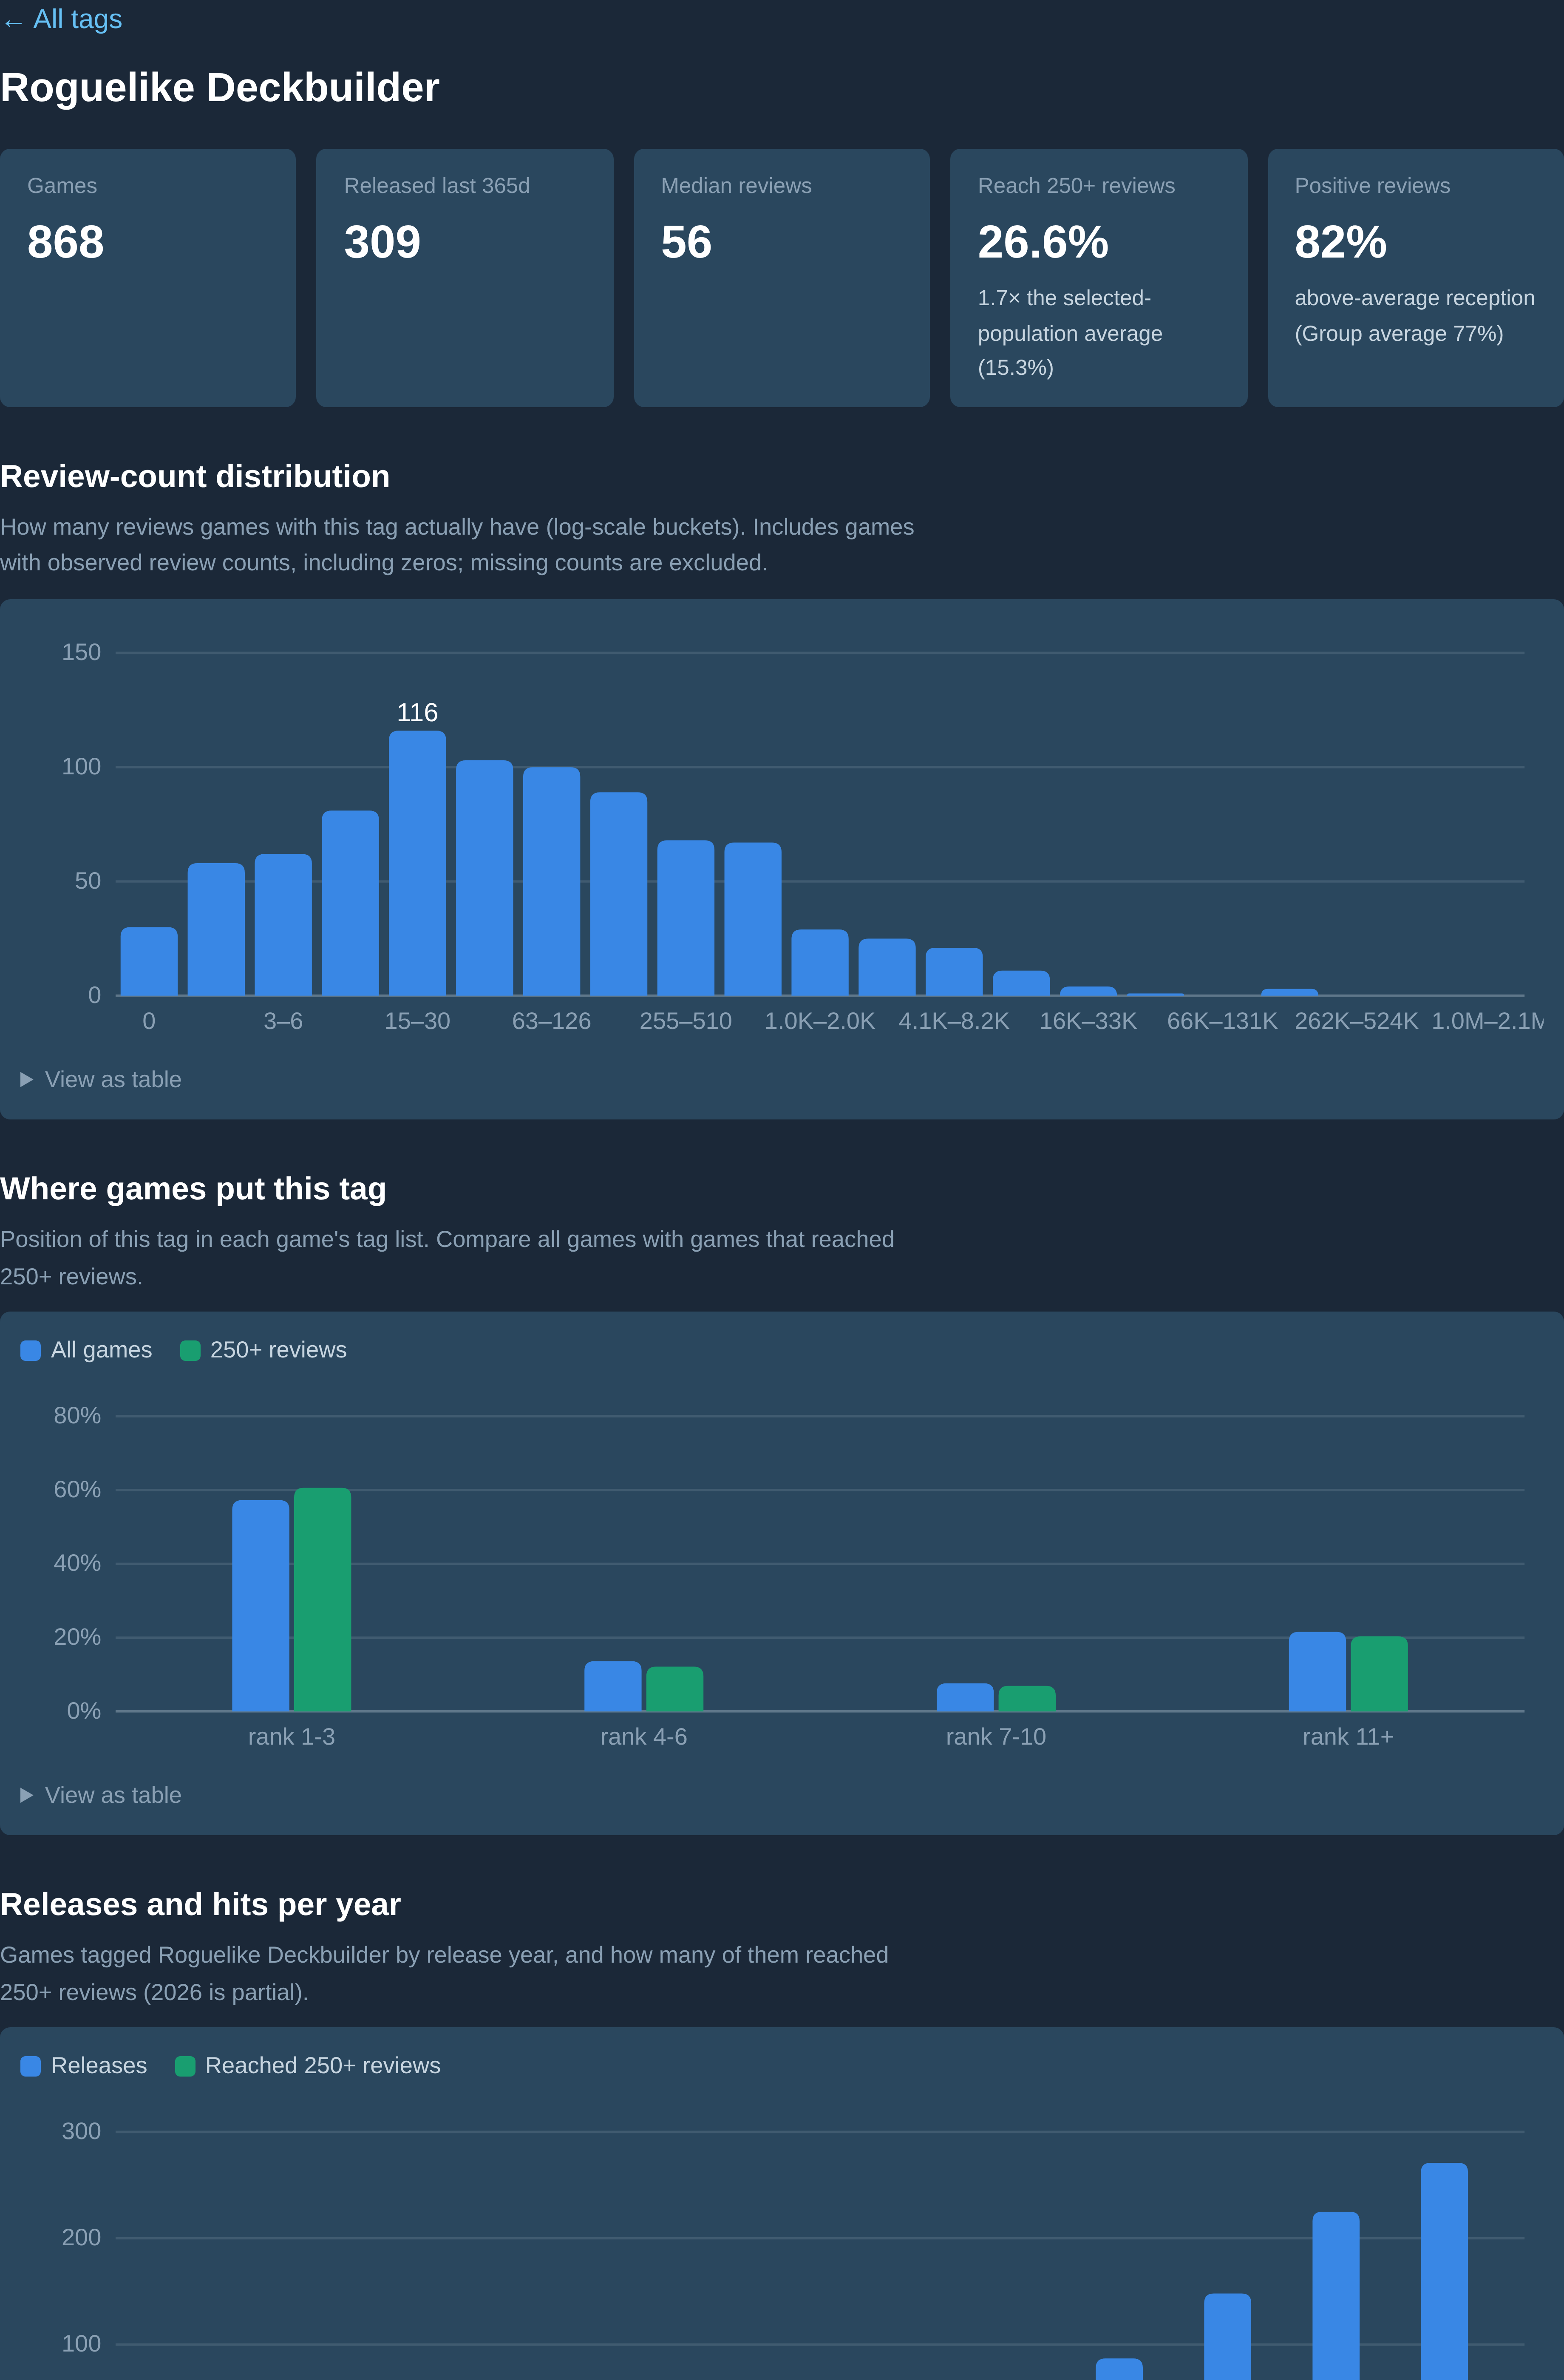
Я также сделал шестнадцать страниц аналитики: обзор тегов, сочетания, тренды, текущие тренды т.д.
Они используют наблюдаемые значения и сравнения отзывов, без оценок выручки отдельных игр. Я показываю медианы, процентильные диапазоны, размеры выборок и интервалы Уилсона для долей игр, достигших заданного порога. Рядом с каждым сравнением указаны соответствующие ограничения данных.
Некоторые находки оказались полезными; другие потребовали более аккуратных формулировок:
-
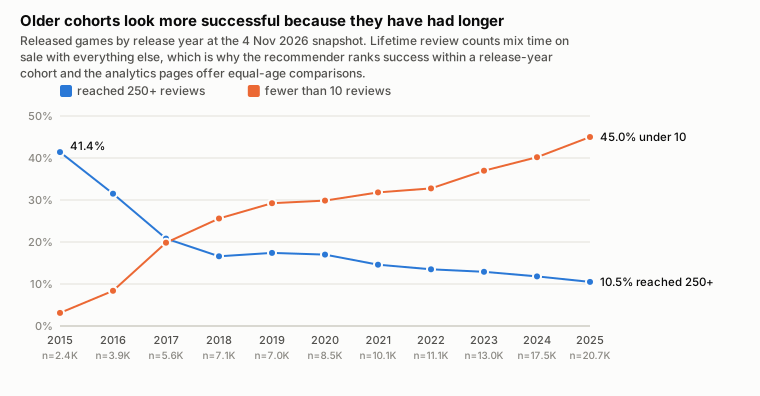
У старых когорт было больше времени на сбор отзывов. У 41% релизов 2015 года набралось 250+ отзывов, против 10.5% релизов 2025 года; у 45% последних меньше десяти отзывов. Состав когорт тоже различается, поэтому возраст — не единственное объяснение. Теперь рекомендатель ранжирует успешность внутри года выхода. При сравнении показателей используются первые три или шесть полных календарных месяцев после релиза, без неполного месяца выхода, либо фильтр по возрасту игры на момент получения числа отзывов.
-
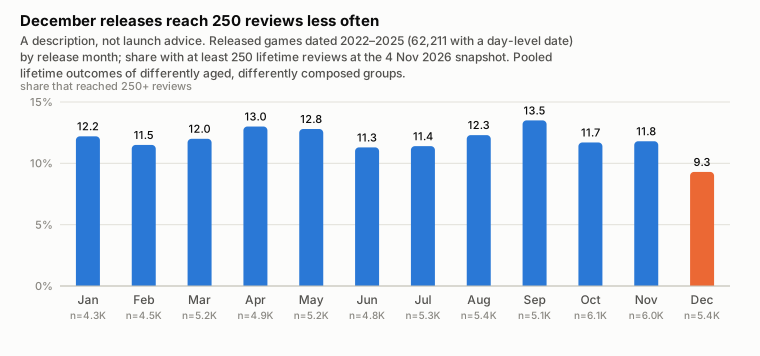
Декабрьские релизы реже достигали 250 отзывов: 9.3% среди релизов 2022–2025 годов, против 13.5% у сентябрьских. Одного этого сравнения недостаточно, чтобы выбирать месяц выхода.
-
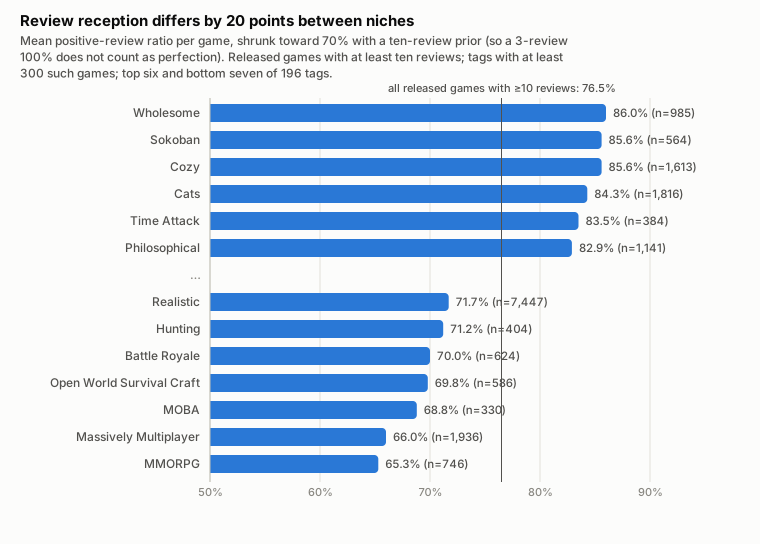
Доля положительных отзывов различается между нишами примерно на 20 процентных пунктов. При априорном сглаживании с весом в десять отзывов Wholesome, Sokoban и Cozy находятся около 86% положительных, а MMORPG — на 65%. Я назвал это «строгостью аудитории», но данные не позволяют отделить влияние аудитории от различий между играми. Сглаживание тоже важно: по обычным средним Sokoban обгоняет Cozy (90.4% против 88.3%), но после применения априорного сглаживания они меняются местами.
-
Хвалебные теги искажают сравнения. В моём первом рейтинге сочетаний на первое место вышло «Online Co-Op + Great Soundtrack». Игроки могут добавить Great Soundtrack уже после того, как игра стала успешной. Надёжно отделить хвалебные теги статистически не получилось: Dark Fantasy вёл себя похожим образом. Я использую небольшой список, составленный вручную, и исключаю почти универсальные теги.
-
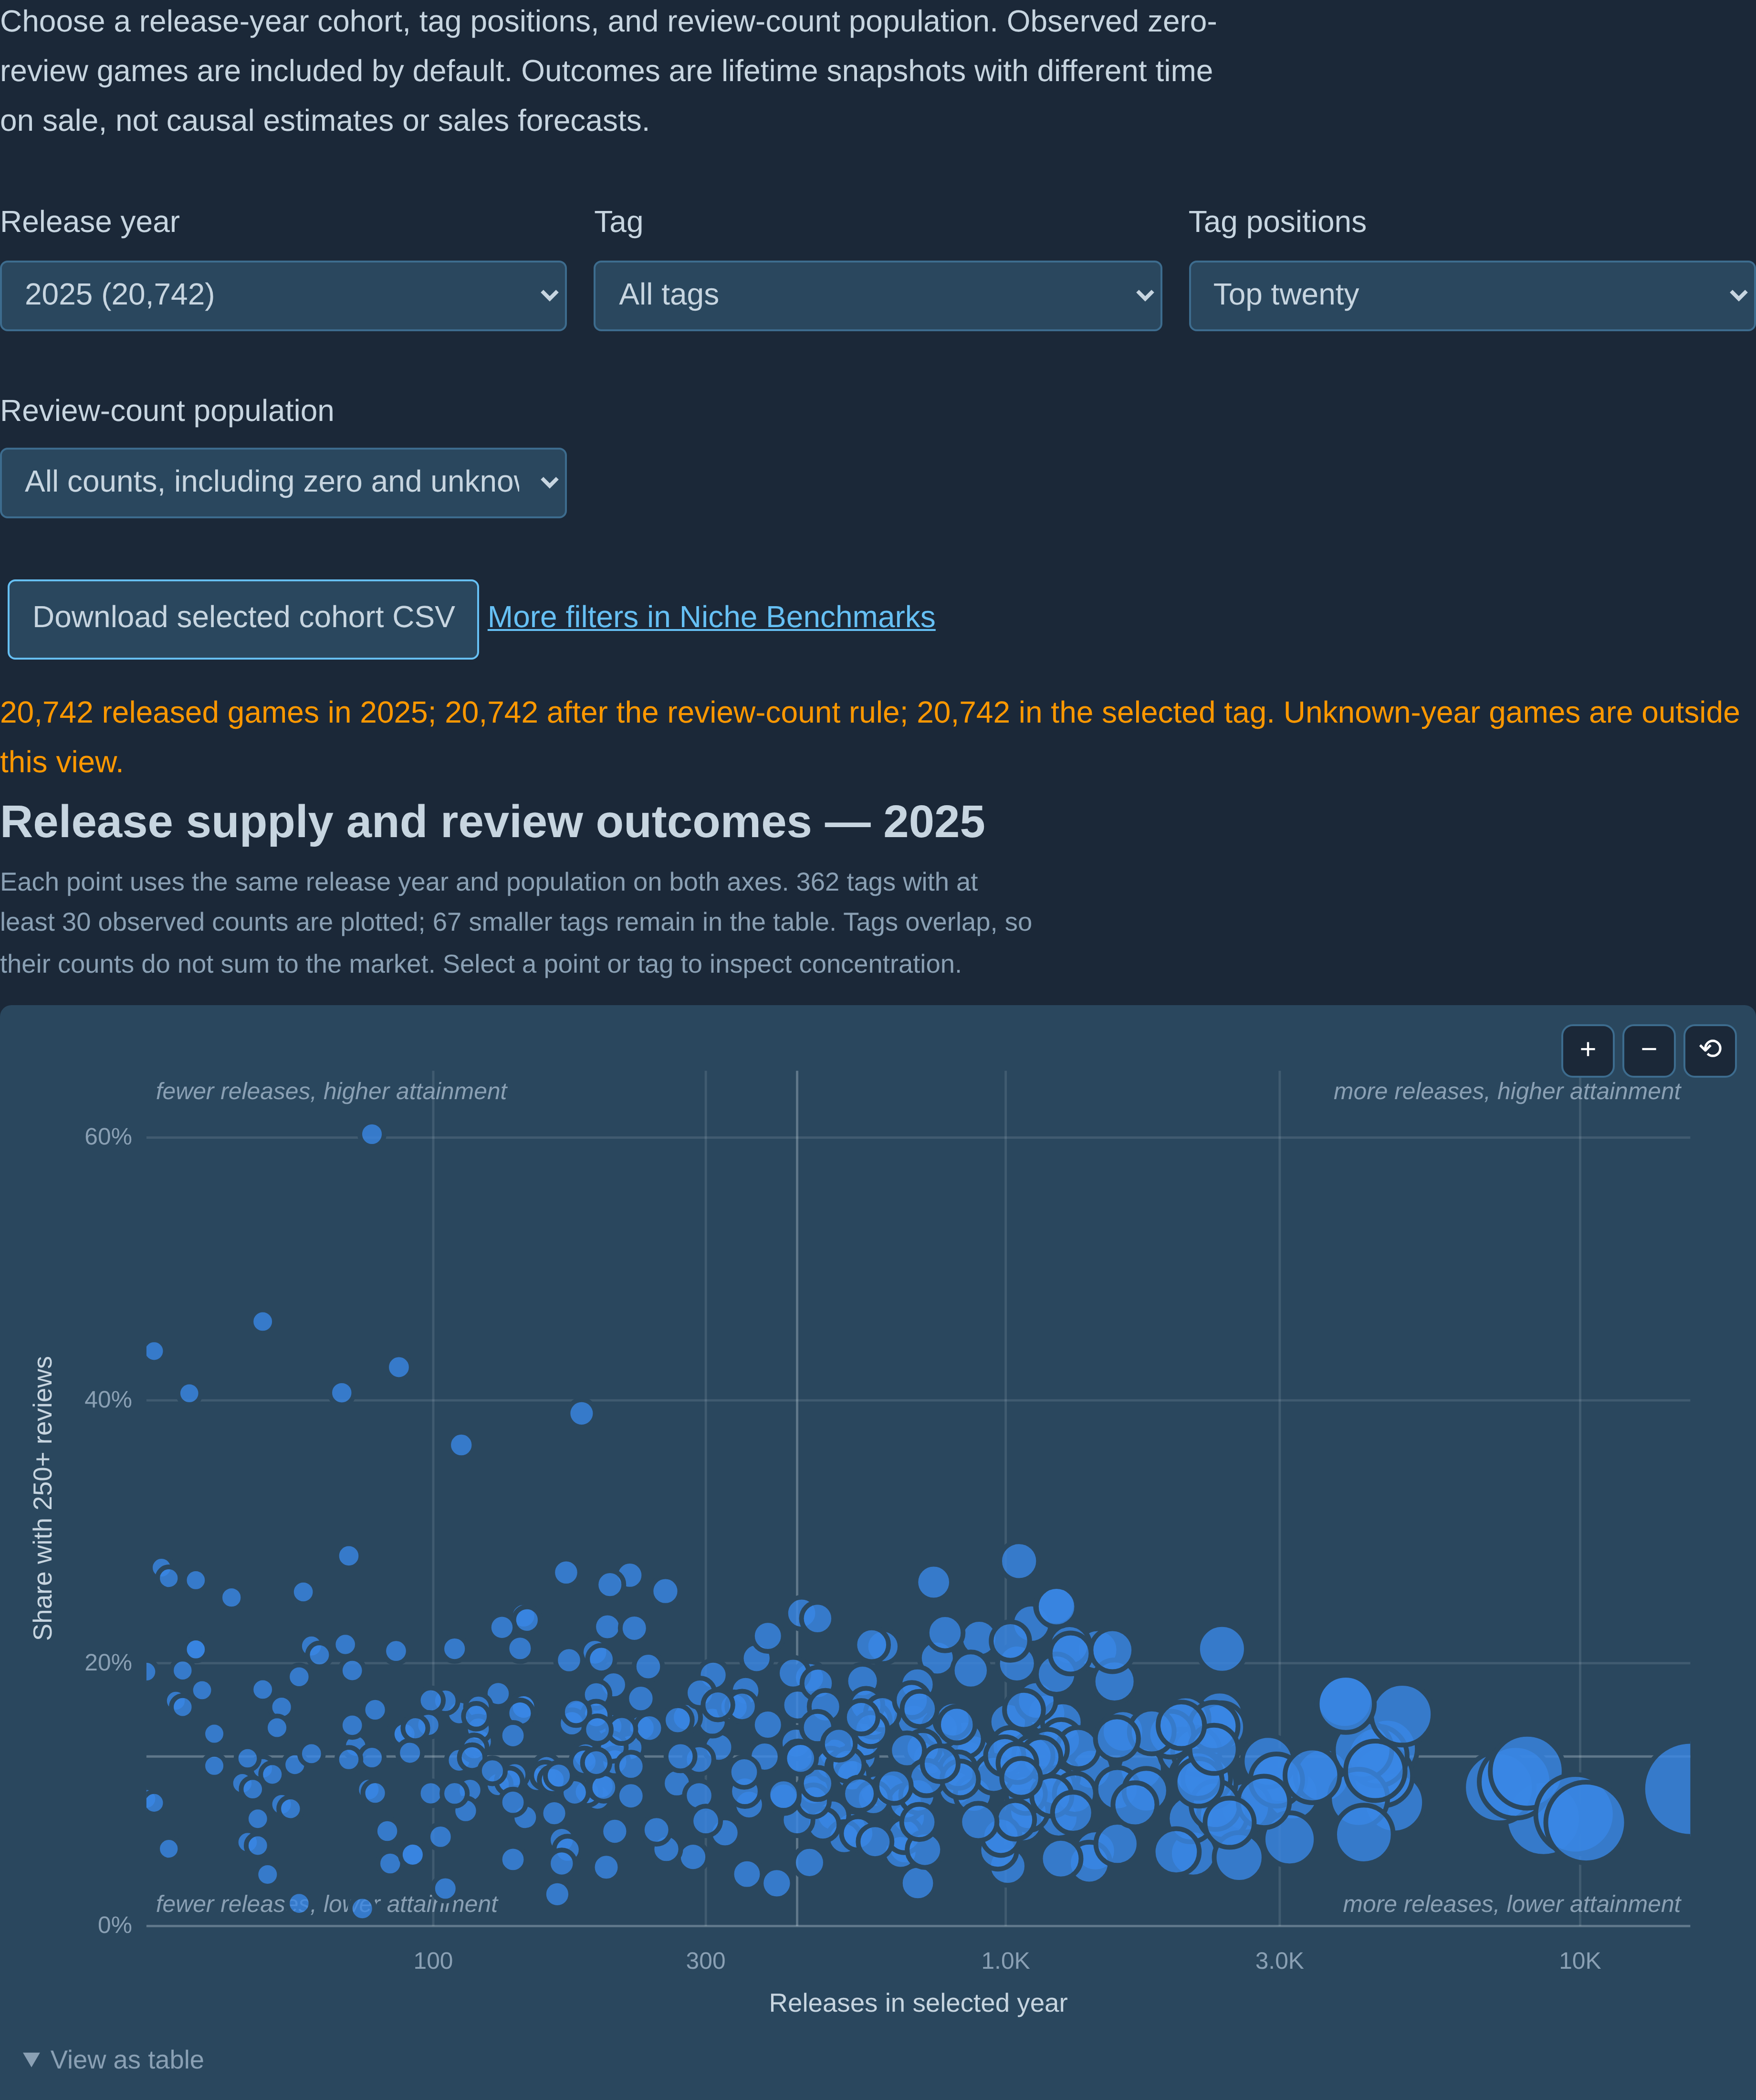
Некоторые названия и сравнения пришлось исправить. Я переименовал «самостоятельно изданные игры», чтобы название отражало реальный критерий: совпадение имён разработчика и издателя. Перестал называть игры с числом отзывов меньше десяти «низкопробными поделками» и исключать их по умолчанию; теперь этот порог опционален. На карте рынка для числа вышедших игр и доли хитов теперь используется один и тот же год выхода, вместо сравнения прошлогодних релизов с результатами за всё время.
Один пользователь попросил улучшить фильтр по возрасту игры:
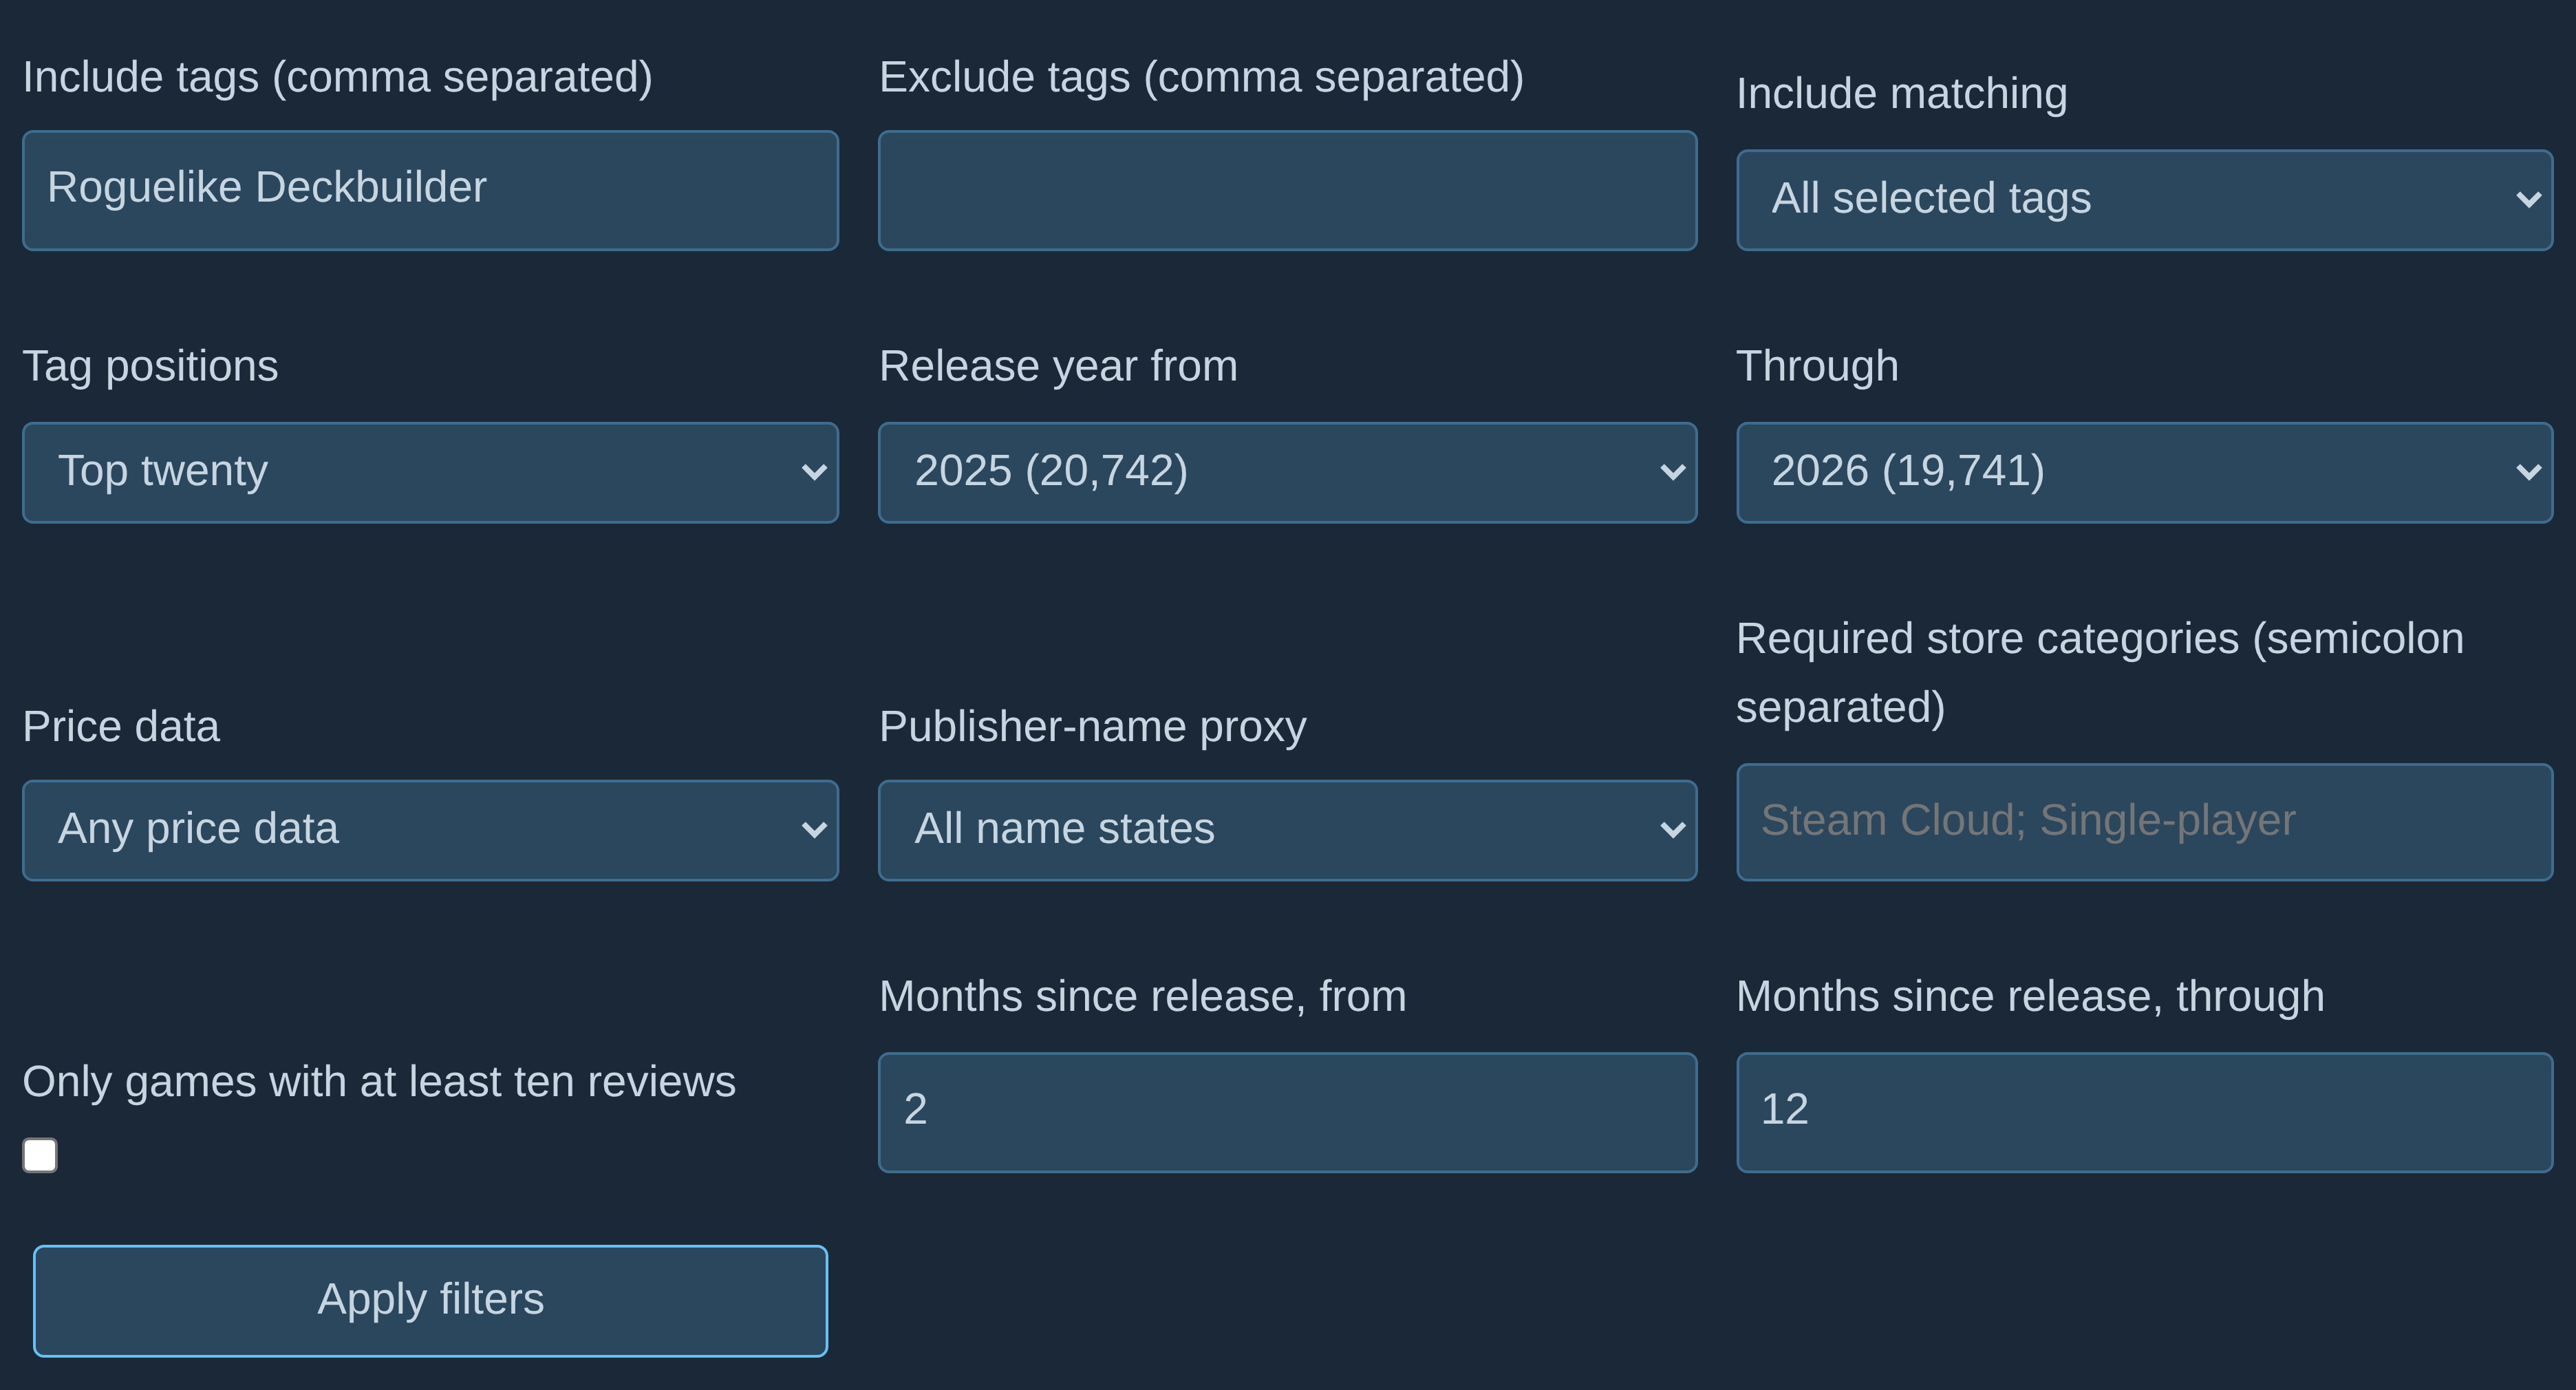
У игры, вышедшей два месяца назад, и у игры, вышедшей пять лет назад, были совершенно разные возможности набрать отзывы. Прежде чем оценивать нишу по доле игр, достигших определённого числа отзывов, я хотел бы выбрать когорту недавних релизов.
Существующим панелям сравнения игр одного возраста требовались проверенные истории отзывов, которых в молодых нишах редко хватало. Я добавил окно по числу месяцев после релиза, измеряемому от даты выхода до даты получения каждого значения числа отзывов. Счётчики обновляются по очереди и могут отставать на недели. Игры без точной даты выхода или полученного числа отзывов исключаются, а количество исключений показывается.
Аналитика публикуется в виде неизменяемых снапшотов с адресами, зависящими от содержимого. Manifest публикуется последним, чтобы неполный экспорт не смешивал данные разных ночных запусков. Каждая сборка сайта закреплена за одним снапшотом, а полную рабочую базу я публикую ежемесячно в GitHub Releases.
Ночные запуски
Сбой сбора отзывов привёл к трём ночам с отчётом «обновлено 5 000 игр», хотя ни одного успешного наблюдения не было. Я добавил в сводку Action отчёт о сборе: сколько запросов запланировано, предпринято, выполнено успешно и завершилось ошибкой, а также примеры ошибок. Перед загрузкой задача запускает регрессионные тесты, а при прерывании сохраняет рабочее состояние в артефакт.
Однажды сбой произошёл и на стороне GitHub — уже после загрузки данных в R2. Финальная отправка служебного коммита, подтверждающего запуск, упала с remote: Internal Server Error, и весь запуск остался красным, несмотря на успешную загрузку. Теперь push повторяется до пяти раз, с fetch и rebase между попытками.
Сколько это потребовало
- Время: первый коммит сделан 31 мая 2026 года. Начальная версия заняла около шести недель работы в свободное время; следующие четыре месяца ушли на проверку тегов, контрольную выборку, изменения сегментов, инструменты для работы с когортами и качество данных.
- Железо: одна потребительская видеокарта для дообучения и кодирования векторов игр. Всё остальное работает на CPU, в основном в бесплатном CI.
- Деньги: GitHub Actions, GitHub Pages и Cloudflare R2 пока укладываются в бесплатные лимиты, плюс домен, который я уже оплачивал.
Результаты GTE-base ниже получены на разных снимках. Прирост каждого изменения измерен относительно собственного контрольного варианта.
| Этап (gte-base) | id_recall@10 | ndcg@10 |
|---|---|---|
| Первая рабочая версия (база за июнь 2026) | 0.499 | 0.423 |
| + исправления поиска упоминаний и сглаживания lift (контролируемый прирост: +0.4) | 0.536 | 0.451 |
| + сложные отрицательные примеры для ранжировщика (контролируемый прирост: +2.2) | 0.529 | 0.452 |
| + kNN по отдельным играм (контролируемый прирост: +11.7) | 0.646 | 0.535 |
| + настройка веса голосов (контролируемый прирост: +4.5) | 0.691 | 0.573 |
| + сегменты по году выхода, включение по первым 5 тегам, дообучение с ограничениями для отрицательных примеров (августовская база) | 0.693 | 0.589 |
| Те же модели, 500 игр из пула, исключённого из обучения энкодера | 0.655 | 0.567 |
| Базовый вариант по популярности (для масштаба) | 0.370 | 0.315 |
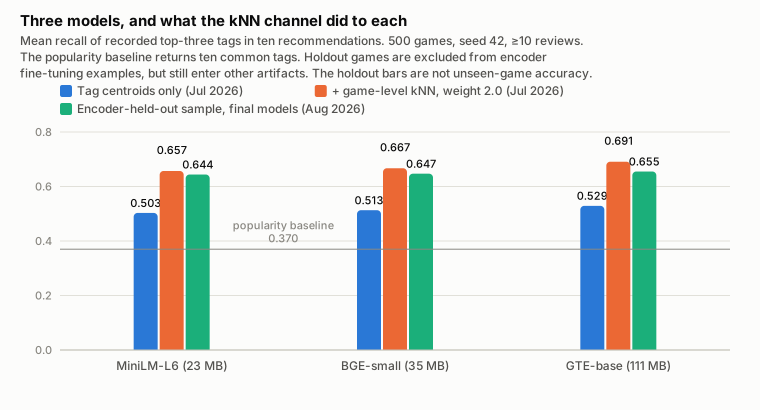
С kNN полнота на контрольной выборке близка у всех моделей: MiniLM — 0.644, BGE-small — 0.647, GTE-base — 0.655. Без оценок неопределённости я не могу сказать, оправдывает ли небольшое преимущество GTE-base загрузку 111 МБ. В июле полнота GTE-base по трём равным группам игр, упорядоченных по числу отзывов от меньшего к большему, составляла 0.696, 0.653 и 0.723. Даже нижняя группа исключает игры с числом отзывов меньше десяти, поэтому эти результаты не подтверждают качество работы на новых играх или играх с небольшим числом отзывов.
Полнота выросла примерно с половины до двух третей основных тегов игры. Метрика по-прежнему поощряет воспроизведение существующих тегов Steam, а не их улучшение.
Что ещё не так
- Размер загрузки: анализатору и проверке тегов всё ещё нужны 388 МБ SQLite до первого результата.
- Оценка качества: контрольная выборка энкодера не устраняет пересечения в ранжировщике и производных данных. Короткие описания невышедших проектов, необычные сочетания жанров и игры с числом отзывов меньше десяти требуют отдельной проверки.
- Шум при обучении: подходящие или повторяющиеся теги могут становиться отрицательными примерами внутри батча при MNRL. Я ещё не проверял, исправит ли это функция потерь с несколькими положительными примерами или маскирование.
- Динамика: я записываю число дней между снимками, но рекомендатель всё ещё использует абсолютную разницу счётчиков, из-за чего интервалы обновления разной длины сложно сравнивать.
- Устаревшие теги: на 4 ноября примерно у 118 000 из 127 000 игр с тегами данные об их назначении были старше 30 дней. Проверка показывает дату сбора, но ей нужен способ получать актуальные теги.
- Коммерческие выводы:
P(tag | top performers) / P(tag | segment)измеряет связь. На неё могут влиять бюджет, издатель, маркетинг и теги, добавленные уже после успеха. Чтобы проверить, помогает ли изменение тегов, нужно контролируемое исследование с данными разработчиков о трафике из Steamworks. - Соответствие браузерной реализации: оценка использует исходный чекпойнт энкодера и Python-логику, которая отличается от TypeScript в обработке выведенных из употребления тегов и исключений из лимита дополнительных тегов. Нужно измерять качество рекомендаций в Node-проверках с настоящим движком, которые уже используются для аудита, включая проверку влияния квантования.
Несколько выводов
- Локальное выполнение упростило хостинг, но оставило мне проблему загрузки 388 МБ.
- Векторы отдельных игр улавливали сочетания, которые терялись в центроидах тегов. Их добавление дало самое большое улучшение.
- После просмотра результатов я оставил вес голосов с более низкой метрикой. Лучший результат на тесте был не единственным критерием.
- Неудачный эксперимент со сложными отрицательными примерами оказался полезным после изменения правил их подбора. Проблема была не только в функции потерь.
- Для отсутствующих данных нужно отдельное состояние. Неудачные запросы, пропущенные месяцы в гистограммах и недоступные соседи вызывали баги, когда трактовались как ноль.
- Сбои сбора часто давали правдоподобные числа. Проверки возраста, проигнорированные параметры, локализованные даты и пустые ответы HTTP 200 — всё это требовало явных проверок.
- Названия нужно проверять не менее тщательно, чем код. «Строгость аудитории» и «самостоятельно изданные игры» обещали больше, чем подтверждали данные.
Стек
-
TypeScript + Vite + sql.js в браузере
-
Transformers.js + ONNX Runtime (int8) для эмбеддингов в Web Worker
-
Python + sentence-transformers + LightGBM вне браузера
-
SQLite
-
GitHub Actions и GitHub Pages
-
Cloudflare R2/CDN, а также небольшой Worker для получения актуальных данных по App ID: он уже написан, но пока не включён.
-
Модели:
P.S. изначально статья была опубликована на английском, поэтому текст на пикчах с английский.